ある日突然、社内のパソコンが一斉に動かなくなったり、顧客情報流出の疑いを指摘されたりしたら、あなたはどう動きますか?
現代のIT社会において、「サイバー攻撃を完全に防ぐ」ことは現実的に不可能と言われています。どんなに強固な壁を築いても、攻撃者はわずかな隙間を見つけて侵入してきます。そのため、現在のセキュリティ対策では、「侵入されることを前提」とし、被害が発生した際にいかに迅速に対応して損害を最小限に抑えるかという「インシデントレスポンス(事故対応)」が極めて重要視されています。
システム運用やセキュリティ担当者にとって、この対応手順が頭に入っているかどうかが、企業の存続を左右すると言っても過言ではありません。
本記事では、NISTやSANSなどのフレームワークをもとに、インシデント発生後の対応の中核となる「検知・封じ込め・根絶・復旧」の4つのステップについて、現場で必要となる判断基準や具体的なアクションを交えて解説します。
インシデントレスポンスとは?「防御」から「対応」へのシフト
インシデントレスポンスとは、ウイルス感染、不正アクセス、情報漏えい、Webサイトの改ざんといった「セキュリティインシデント」が発生した際に、組織として行う一連の対応活動のことを指します。消防署が火災発生時に消火活動を行い、原因を調査し、再発防止策を講じるのと全く同じ図式です。
「サイバーレジリエンス」という考え方
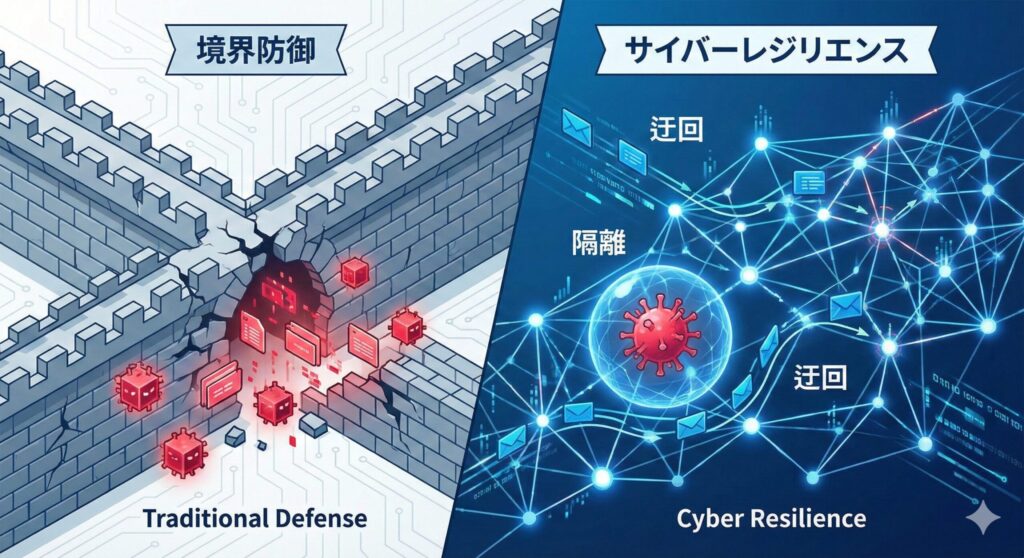
かつてのセキュリティ対策は、ファイアウォールやアンチウイルスソフトで「境界防御」を固め、侵入させないことに全力を注いでいました。しかし、クラウドサービスの普及やテレワークの拡大により「守るべき境界」が曖昧になり、さらに攻撃手法が高度化したことで、防御を突破されるケースが後を絶ちません。
そこで重要になってくるのが「サイバーレジリエンス(回復力)」という概念です。攻撃を受けてもシステムダウンを短時間に留め、ビジネスを継続・復旧させる能力を指します。インシデントレスポンスは、このレジリエンスを高めるための核心的なプロセスとなります。
NISTが定義するインシデントレスポンスの標準フロー
最初に用語を整理しておきます。本記事では、NIST SP 800-61 Rev.2の「4フェーズ」のうち、インシデント発生後の実働部分(検知・分析と、封じ込め・根絶・復旧)を「4つのステップ」に分けて解説します。タイトルの「4つのフェーズ」はNISTの4フェーズを指し、本文の「ステップ1〜4」は記事独自の区分です。
インシデントレスポンスの流れには、いくつかの標準的なフレームワークが存在します。最も代表的なのが、米国国立標準技術研究所(NIST)が発行する「SP 800-61 Rev.2(コンピュータセキュリティインシデント対応ガイド)」(2012年)です。
このガイドラインでは、対応プロセスを以下の4つのフェーズに分類しています:
- 準備(Preparation)
- 検知と分析(Detection and Analysis)
- 封じ込め・根絶・復旧(Containment, Eradication, and Recovery)
- 事後対応(Post-Incident Activity)
試験対策としても実務としても、この4フェーズを順序通りに理解し、各フェーズで「何を最優先すべきか」を把握しておくことが重要です。ただし実際には、根絶の途中で新たな痕跡が見つかれば検知と分析に戻るなど、各フェーズを行き来しながら反復して進めます(NIST SP 800-61 Rev.2の第3章)。
なお、NISTは2025年4月に改訂版の SP 800-61 Rev.3 を公開し、Rev.2を置き換えました。Rev.3では、上記の4フェーズのライフサイクルに代えて、CSF 2.0(サイバーセキュリティフレームワーク2.0)の6つの機能(統治・識別・防御・検知・対応・復旧)に沿ってインシデント対応を整理しています。本記事では、試験対策の基本の型としてRev.2の4フェーズを使います。
本記事の4つのステップは「検知と分析・封じ込め・根絶・復旧」で、最後にNISTの4フェーズ目にあたる事後対応を扱います(準備については「インシデントレスポンスを成功させるための3つのポイント」で触れます)。SANSのモデル(準備・識別・封じ込め・根絶・復旧・教訓)も、ほぼ同じ流れです。
テンプレート集
+おまけ:毎日1通の無料メール講座つき。登録した日が「1日目」、図解と論理で16週間かけて基礎も固まります。
ステップ1:検知と分析(Detection and Analysis)
インシデント対応のトリガーとなるのが「検知」です。しかし、これが最も難しいステップでもあります。サイバー攻撃者が数ヶ月にわたって、誰にも気づかれずにネットワーク内に潜伏していたケースも珍しくないからです。
インシデント検知のための主な情報源
インシデントを検知するきっかけは多岐にわたります:
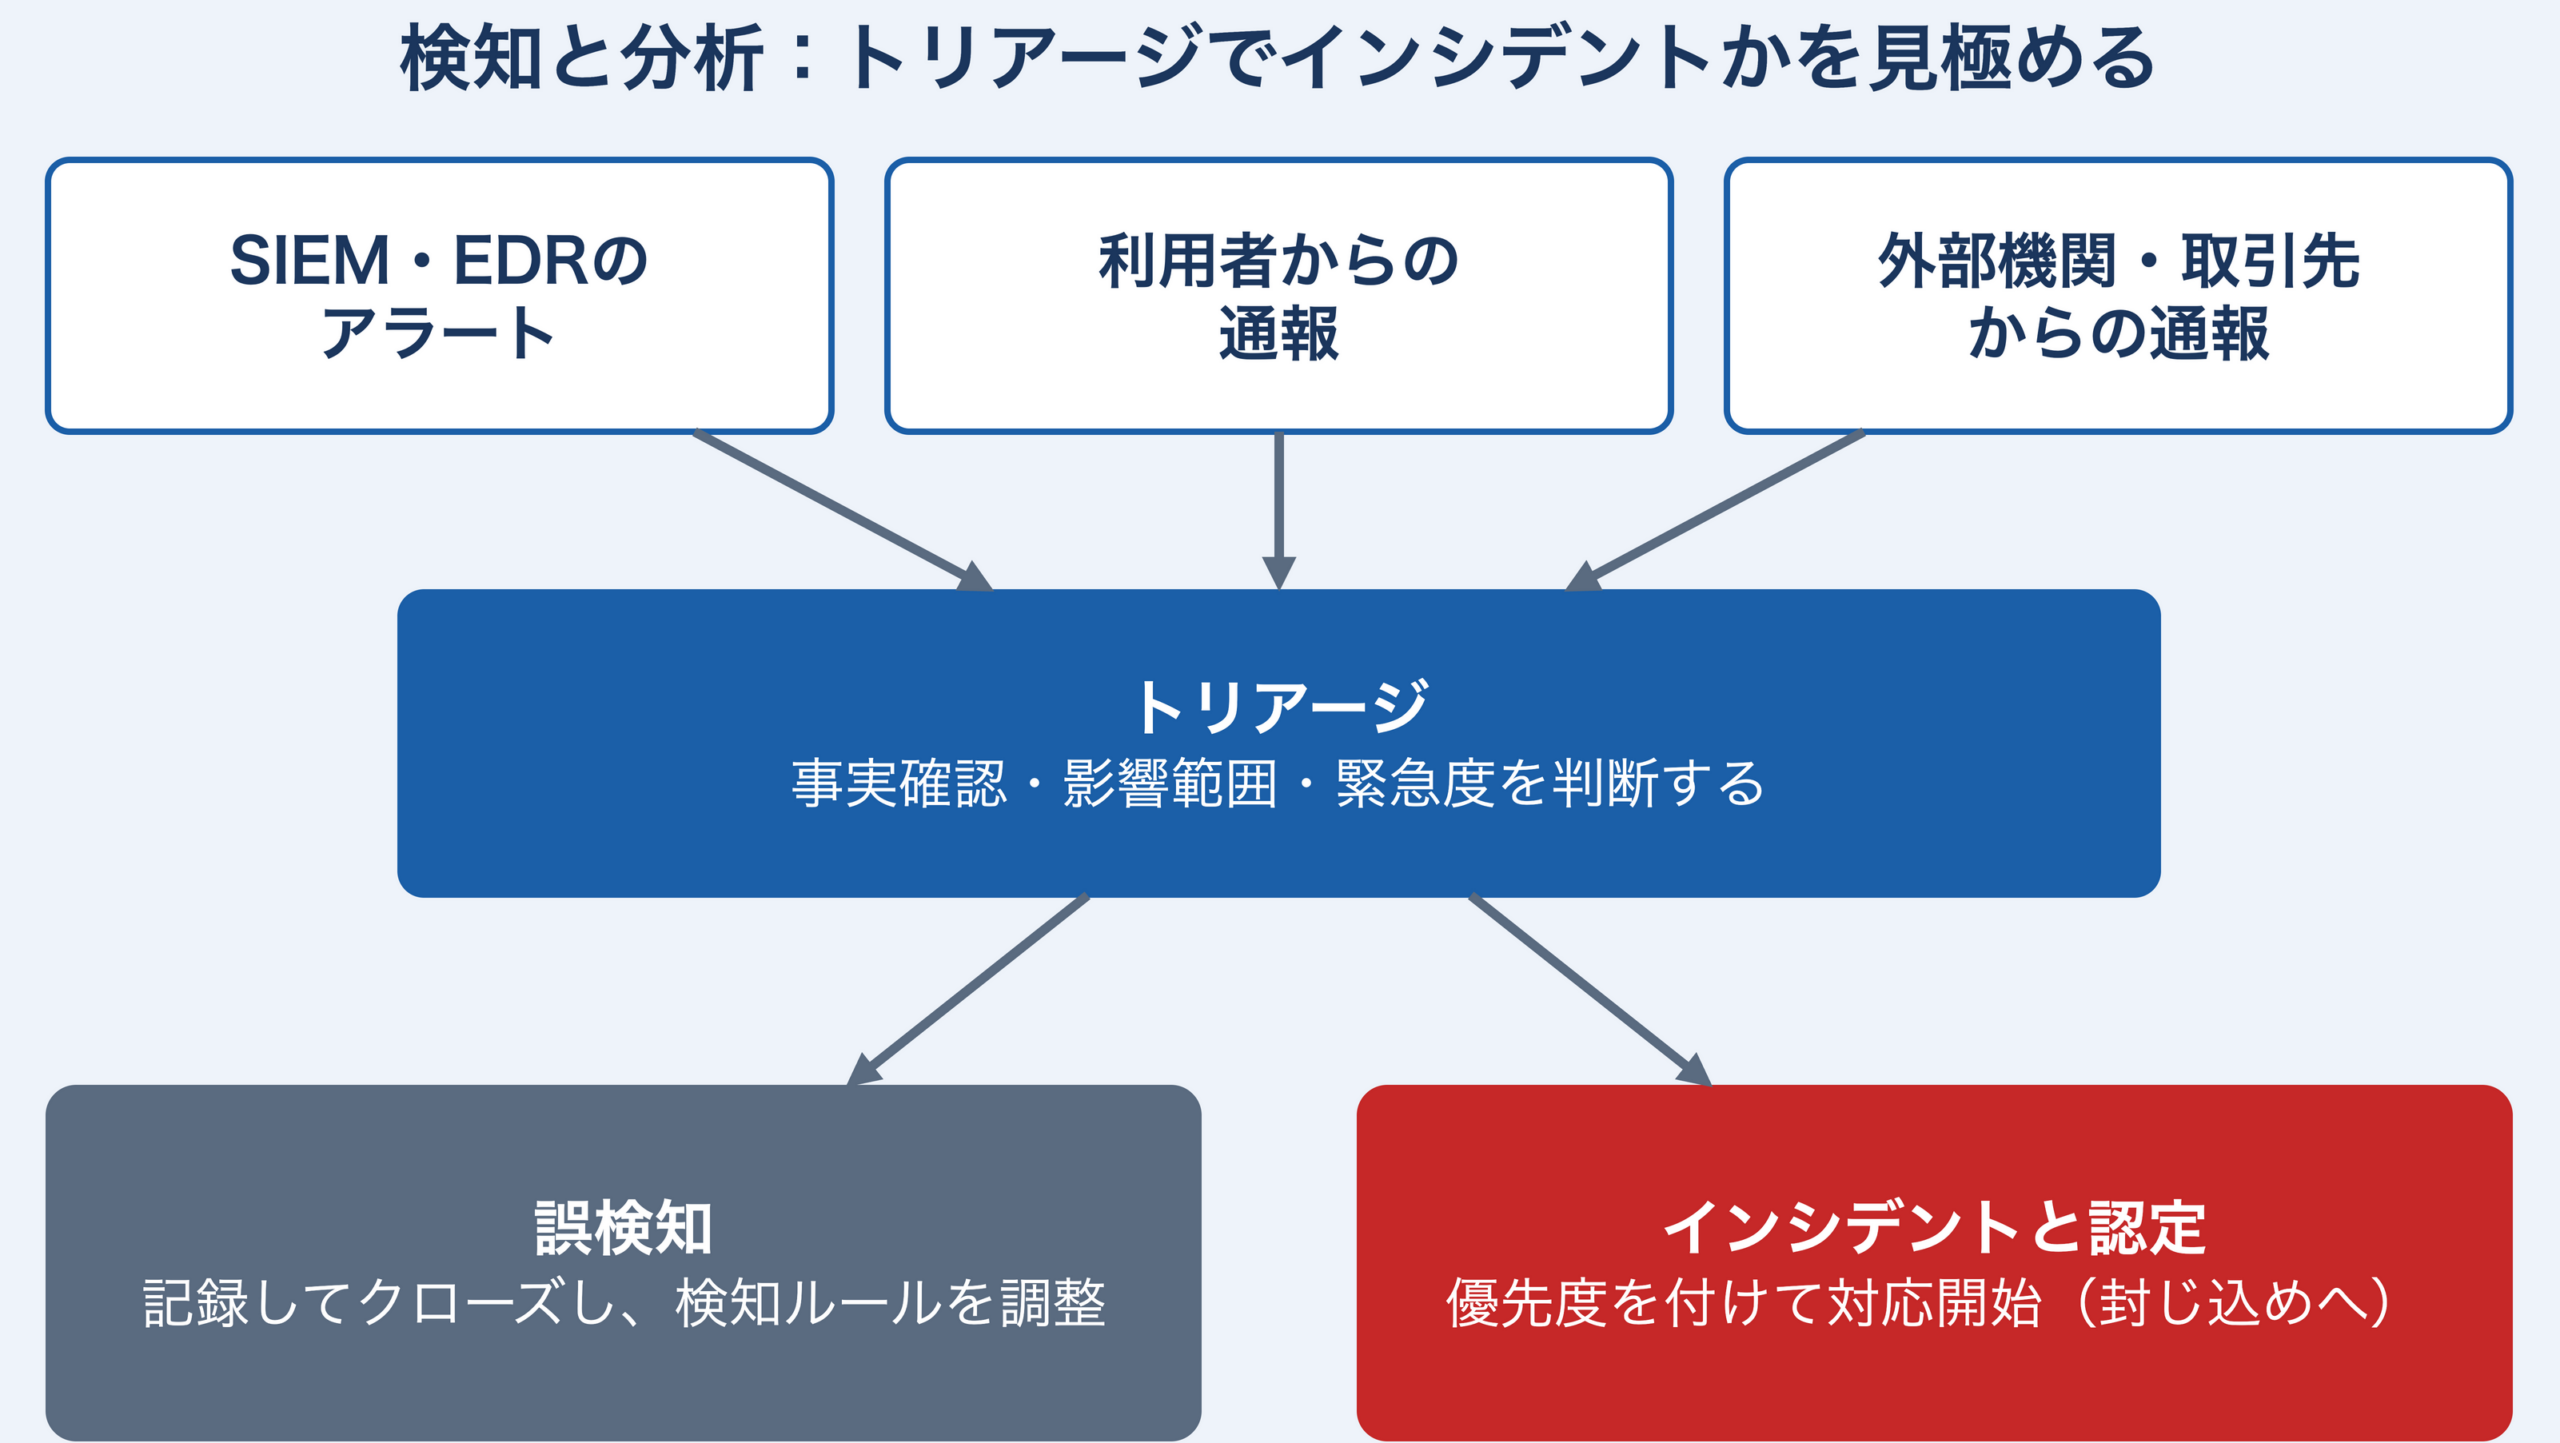
- セキュリティ機器のアラート:ファイアウォール、IDS/IPS(侵入検知システム/侵入防止システム)、アンチウイルスソフトからの警告
- ログの異常:サーバーやネットワーク機器のログに見られる不審な通信、深夜の大量データ送信、管理者権限の不正利用など
- ユーザーからの通報:「パソコンの動作が極端に重い」「身代金を要求する画面が表示された」「不審なメールを開いてしまった」といった現場からの報告
- 外部からの指摘:クレジットカード会社からの不正利用連絡や、セキュリティ専門機関(JPCERT/CCなど)からの通知
アラートの選別(トリアージ)が重要な理由
セキュリティ監視センター(SOC)や運用担当者の元には、日々大量のアラートが届きます。その中には、実際には攻撃ではない「誤検知」(フォールスポジティブ)も多く含まれています。
全てのアラートに全力で対応することはリソース的に不可能です。そのため、届いたアラートが本当に脅威なのか、緊急度はどの程度かを判断する「トリアージ」(選別)が必要になります。
トリアージで確認すべき3つのポイント:
- 影響範囲の特定:どのサーバー、どの端末が影響を受けているか
- 情報の重要度:その端末には顧客情報や機密情報が含まれているか
- 攻撃の進行度:すでに侵入されているのか、スキャン(偵察)段階なのか
トリアージの結果は、次の2つに分かれます。
- 誤検知と判断したもの:無視するのではなく、判断の根拠を記録してクローズします。同じ誤検知が繰り返し上がってくる場合は、しきい値や除外条件などの検知ルールを調整します
- インシデントと認定したもの:上の3つのポイントをもとに優先度を付け、対応を始めます
「これはインシデントである」と認定した時点から、組織は緊急時モード(CSIRT等の出動)へと切り替わります。
最新の検知技術:EDRとSIEMの活用
従来のアンチウイルスソフトは「既知のマルウェア」をパターンマッチングで検知していましたが、未知の攻撃やファイルレス攻撃(ファイルを作らずメモリ上で実行される攻撃)は検知できない場合があります。
そこで普及しているのがEDR(Endpoint Detection and Response)です。PCやサーバー(エンドポイント)の挙動を記録・監視し、「不審な動き」を検知して、調査や対応を支援します。EDRはアンチウイルスなどのEPP(Endpoint Protection Platform)を置き換えるものではなく、併用するのが一般的です。例えば、「Wordファイルを開いただけなのに、PowerShellが裏で起動し、外部サーバーと通信を始めた」といった異常な振る舞いも、検知ルールに合致すれば検知できます。
また、社内のあらゆる機器(ファイアウォール、プロキシ、ADサーバー、EDRなど)のログを一箇所に集め、相関分析を行うSIEM(Security Information and Event Management)の重要性も増しています。例えば、ADで「ログイン失敗の連続」があり、その後「同じアカウントでのログイン成功」があり、さらに「そのアカウントが使った端末からの深夜の大量データ送信」がプロキシのログに残っていたとします。1つのログだけでは判断できませんが、これらを同じアカウント・同じ端末で照合できれば、「アカウント乗っ取りによる情報窃取の疑い」として調査の起点にできます。乗っ取りかどうかは、送信先や送信内容、本人への確認などで裏付けを取ってから判断します。
ステップ2:封じ込め(Containment)
インシデントと認定したら、次に行うべきは「止血」です。被害がこれ以上拡大しないようにシステムをコントロール下に置くことを「封じ込め」と呼びます。このステップは時間との勝負であり、かつ最も冷静な判断が求められる場面です。
短期的な封じ込めと長期的な封じ込め
封じ込めには、即効性を重視した対応と、業務への影響を考慮した対応の2段階があります。
短期的な封じ込めでは、攻撃の拡散を防ぐことが最優先です:
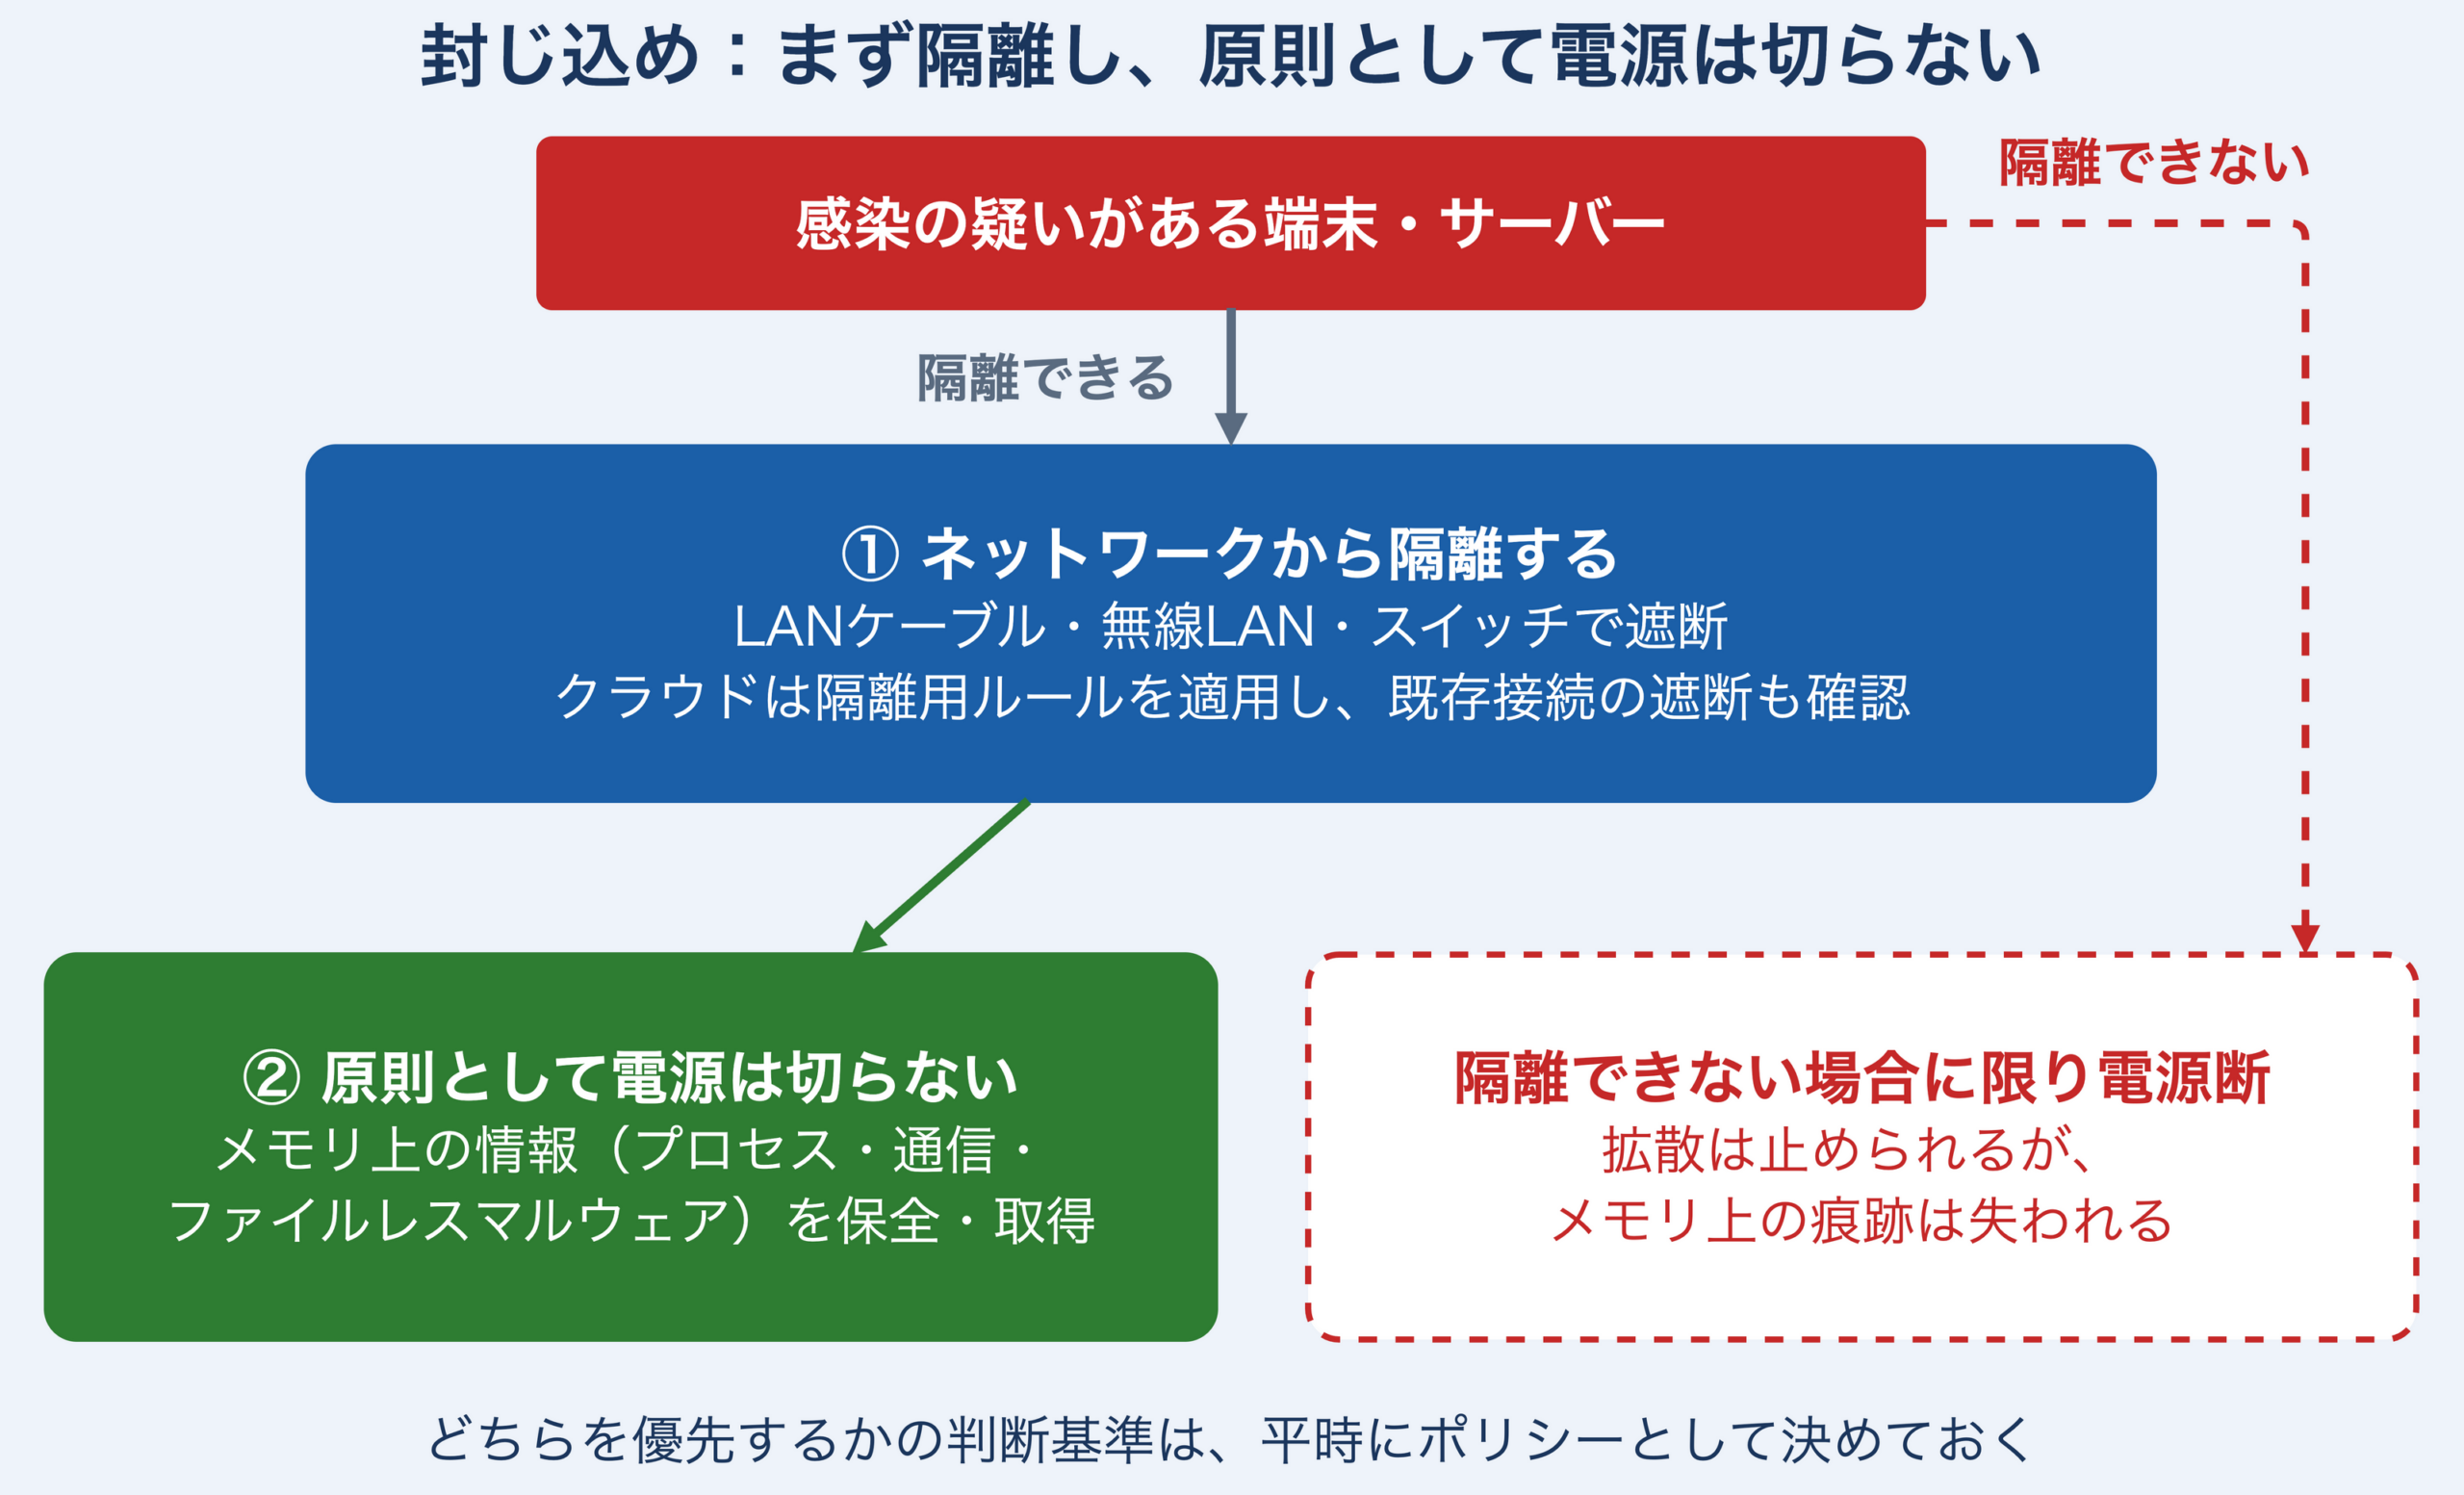
- 感染したPCをネットワークから切り離す(LANケーブルを抜く、無線LANをオフにする)
- 不正通信を行っているサーバーの通信ポートを遮断する
- 攻撃者のC&Cサーバー(指令サーバー)との通信をファイアウォールでブロックする
長期的な封じ込めでは、システムを稼働させながら、根本解決までの時間を稼ぐための措置を実施します:
- 暫定的なパッチ(修正プログラム)の適用
- パスワードの強制リセット
- アクセス制御の強化
封じ込め時のネットワーク分離手法
封じ込めにおいて「ネットワークからの切り離し」は基本ですが、最近のネットワーク環境は複雑化しています。
- 論理隔離(VLAN・SDN・セキュリティグループ):物理的にケーブルを抜くことが難しいデータセンターでは、VLAN設定の変更やSDN(Software Defined Networking)により、感染端末を「検疫ネットワーク」へ隔離する手法がとられます。クラウド環境では、利用者がVLANを変更できないのが通常のため、セキュリティグループやNSG(ネットワークセキュリティグループ)を通信を絞った隔離用のルールに差し替えて隔離します。ただし、ルールを変更しても、確立済みの接続(AWSの追跡対象の接続、Azure NSGの既存の接続など)はすぐには切れない場合があります。隔離用ルールを適用したら、既存の接続も含めて遮断できたことを確認し、クラウドサービスの仕様に応じ、既存の接続も遮断できる追加の措置を講じます。例えばAWSでは、影響範囲を確認したうえでネットワークACLによる遮断を検討します(ネットワークACLはステートレスなので、確立済みの通信も遮断できます)
- アカウントの無効化:ランサムウェアなどでは、特権ID(管理者権限)が乗っ取られ、攻撃に使われるケースが多くあります。端末の隔離と同時に、侵害された疑いのあるActive Directoryアカウントを一時的に無効化(Disabled)することも、重要な封じ込め策の一つです
重要な注意点:証拠保全か、被害拡大防止か
ここで判断を誤りやすいのが、慌てて感染したPCの電源を落としてしまうことです。
電源を切ると、メモリ上にしかない情報(実行中のプロセス、ネットワーク接続の状態、メモリ上だけで動くファイルレスマルウェアなど)が失われます。ディスク上のファイルは残りますが、攻撃の全体像を追う手がかりの一部が消えてしまいます。そのため、原則として電源を切らずにネットワークから隔離し、法的な対応や詳細な原因究明(フォレンジック)が必要になりそうな場合はメモリを取得します。証拠の収集と保管の指針であるRFC 3227も、揮発性の高いもの(レジスタ・キャッシュ、次にルーティングテーブル・ARPキャッシュ・プロセステーブル・メモリなど)から順に収集するよう示しています。
ランサムウェアでも、考え方の基本は同じです。ランサムウェアの多くはファイル単位で暗号化を進め、ネットワーク経由で共有フォルダや他の端末にも被害を広げます。そのため、まず感染した端末をネットワークから切り離します。CISA(米国サイバーセキュリティ・社会基盤安全保障庁)のランサムウェアガイドも、影響を受けたシステムを直ちに隔離し、ネットワークから切り離せない場合に限って電源を切るよう示しています。電源を切る場合は、メモリ上の痕跡が失われることを理解したうえで選ぶ手段になります。
この「証拠保全を優先するか、被害拡大防止を優先するか」の判断基準を、平時のうちにポリシーとして決めておくことが重要です。
ステップ3:根絶(Eradication)
封じ込めに成功し、被害の拡大が止まったら、次はシステムから脅威を取り除く「根絶」のステップに入ります。ここでは、原因の除去と再発防止のための修正を行います。
根本原因の特定と排除
単にウイルス対策ソフトで検知されたマルウェアを削除するだけでは不十分です。「なぜ感染したのか?」という侵入経路を特定しなければ、すぐにまた同じ穴から侵入されてしまいます。
根絶のステップで実施すべき主な作業:
- マルウェアの駆除:全ての感染端末から悪意あるファイルを削除
- バックドアの発見と削除:攻撃者が次回侵入するために設置した「裏口(バックドア)」がないか、不明なユーザーアカウントやタスクスケジューラに登録された不審なタスク(スケジュールタスク)を確認し、削除
- 脆弱性の修正:侵入の原因となったOSやアプリケーションの脆弱性にパッチを適用。また、設定ミス(弱いパスワード、公開すべきでないポートの開放など)を修正
デジタルフォレンジックによる徹底調査
根絶を確実にするためには、「何が起きたか」を正確に知る必要があります。ここで登場するのがデジタルフォレンジックです。
- ディスクフォレンジック:HDDなどの記憶媒体を保全・解析し、削除されたファイルの復元や、マルウェアの実体特定を行う
- メモリフォレンジック:揮発性メモリ(RAM)の内容を解析し、実行中のプロセスやネットワーク接続状況、メモリ上にしか存在しないマルウェアを特定
- ネットワークフォレンジック:パケットキャプチャデータなどを解析し、どのような通信が行われ、どのようなデータが流出したかを特定
これらの調査結果をもとに、「このIPアドレスからの通信を全てブロックする」「このハッシュ値を持つファイルを全社一斉に削除する」といった、具体的かつ効果的な根絶策を実行に移します。
クリーンアップの徹底:再インストールも選択肢
根絶のステップでは、「本当にすべて消えたのか?」という疑いを持つことが大切です。高度な攻撃者は、正規のツール(PowerShellなど)を悪用したり、システムファイルに偽装したりして潜伏します。
場合によっては、システムの一部修正ではなく、OSの再インストール(初期化)や、バックアップからのリストアを選択する方が、安全かつ確実なケースも多々あります。特にルートキットと呼ばれる深層に潜むマルウェアの場合、完全な駆除は困難だからです。ただし、再インストールは封じ込めの後に行います。封じ込め前に再インストールすると、証拠が失われるうえ、他の端末からの再感染を防げません。
ステップ4:復旧(Recovery)
脅威が取り除かれたクリーンなシステムを、通常の業務状態に戻すのが「復旧」のステップです。ここでは「いつ、どのように再開するか」という経営的な判断も関わってきます。
段階的なサービスの再開プロセス
システムを一気に全開にするのではなく、慎重に段階を踏んで再開します:
- リストア:クリーンなバックアップデータからシステムを復元。この際、バックアップデータ自体が汚染されていないかの確認が必要
- テスト稼働:限定されたユーザーやネットワーク内でのみシステムを動かし、正常に動作するか、再び攻撃を受けないかを確認
- 監視強化:復旧直後は、攻撃者の「出戻り」を警戒すべき時期。通常時よりもログ監視のレベルを上げ、不審な挙動がないか厳重にチェック(例:SOCによる24時間監視の強化)
- 完全再開:安全性が確認された段階で、一般ユーザーへのサービス提供を再開
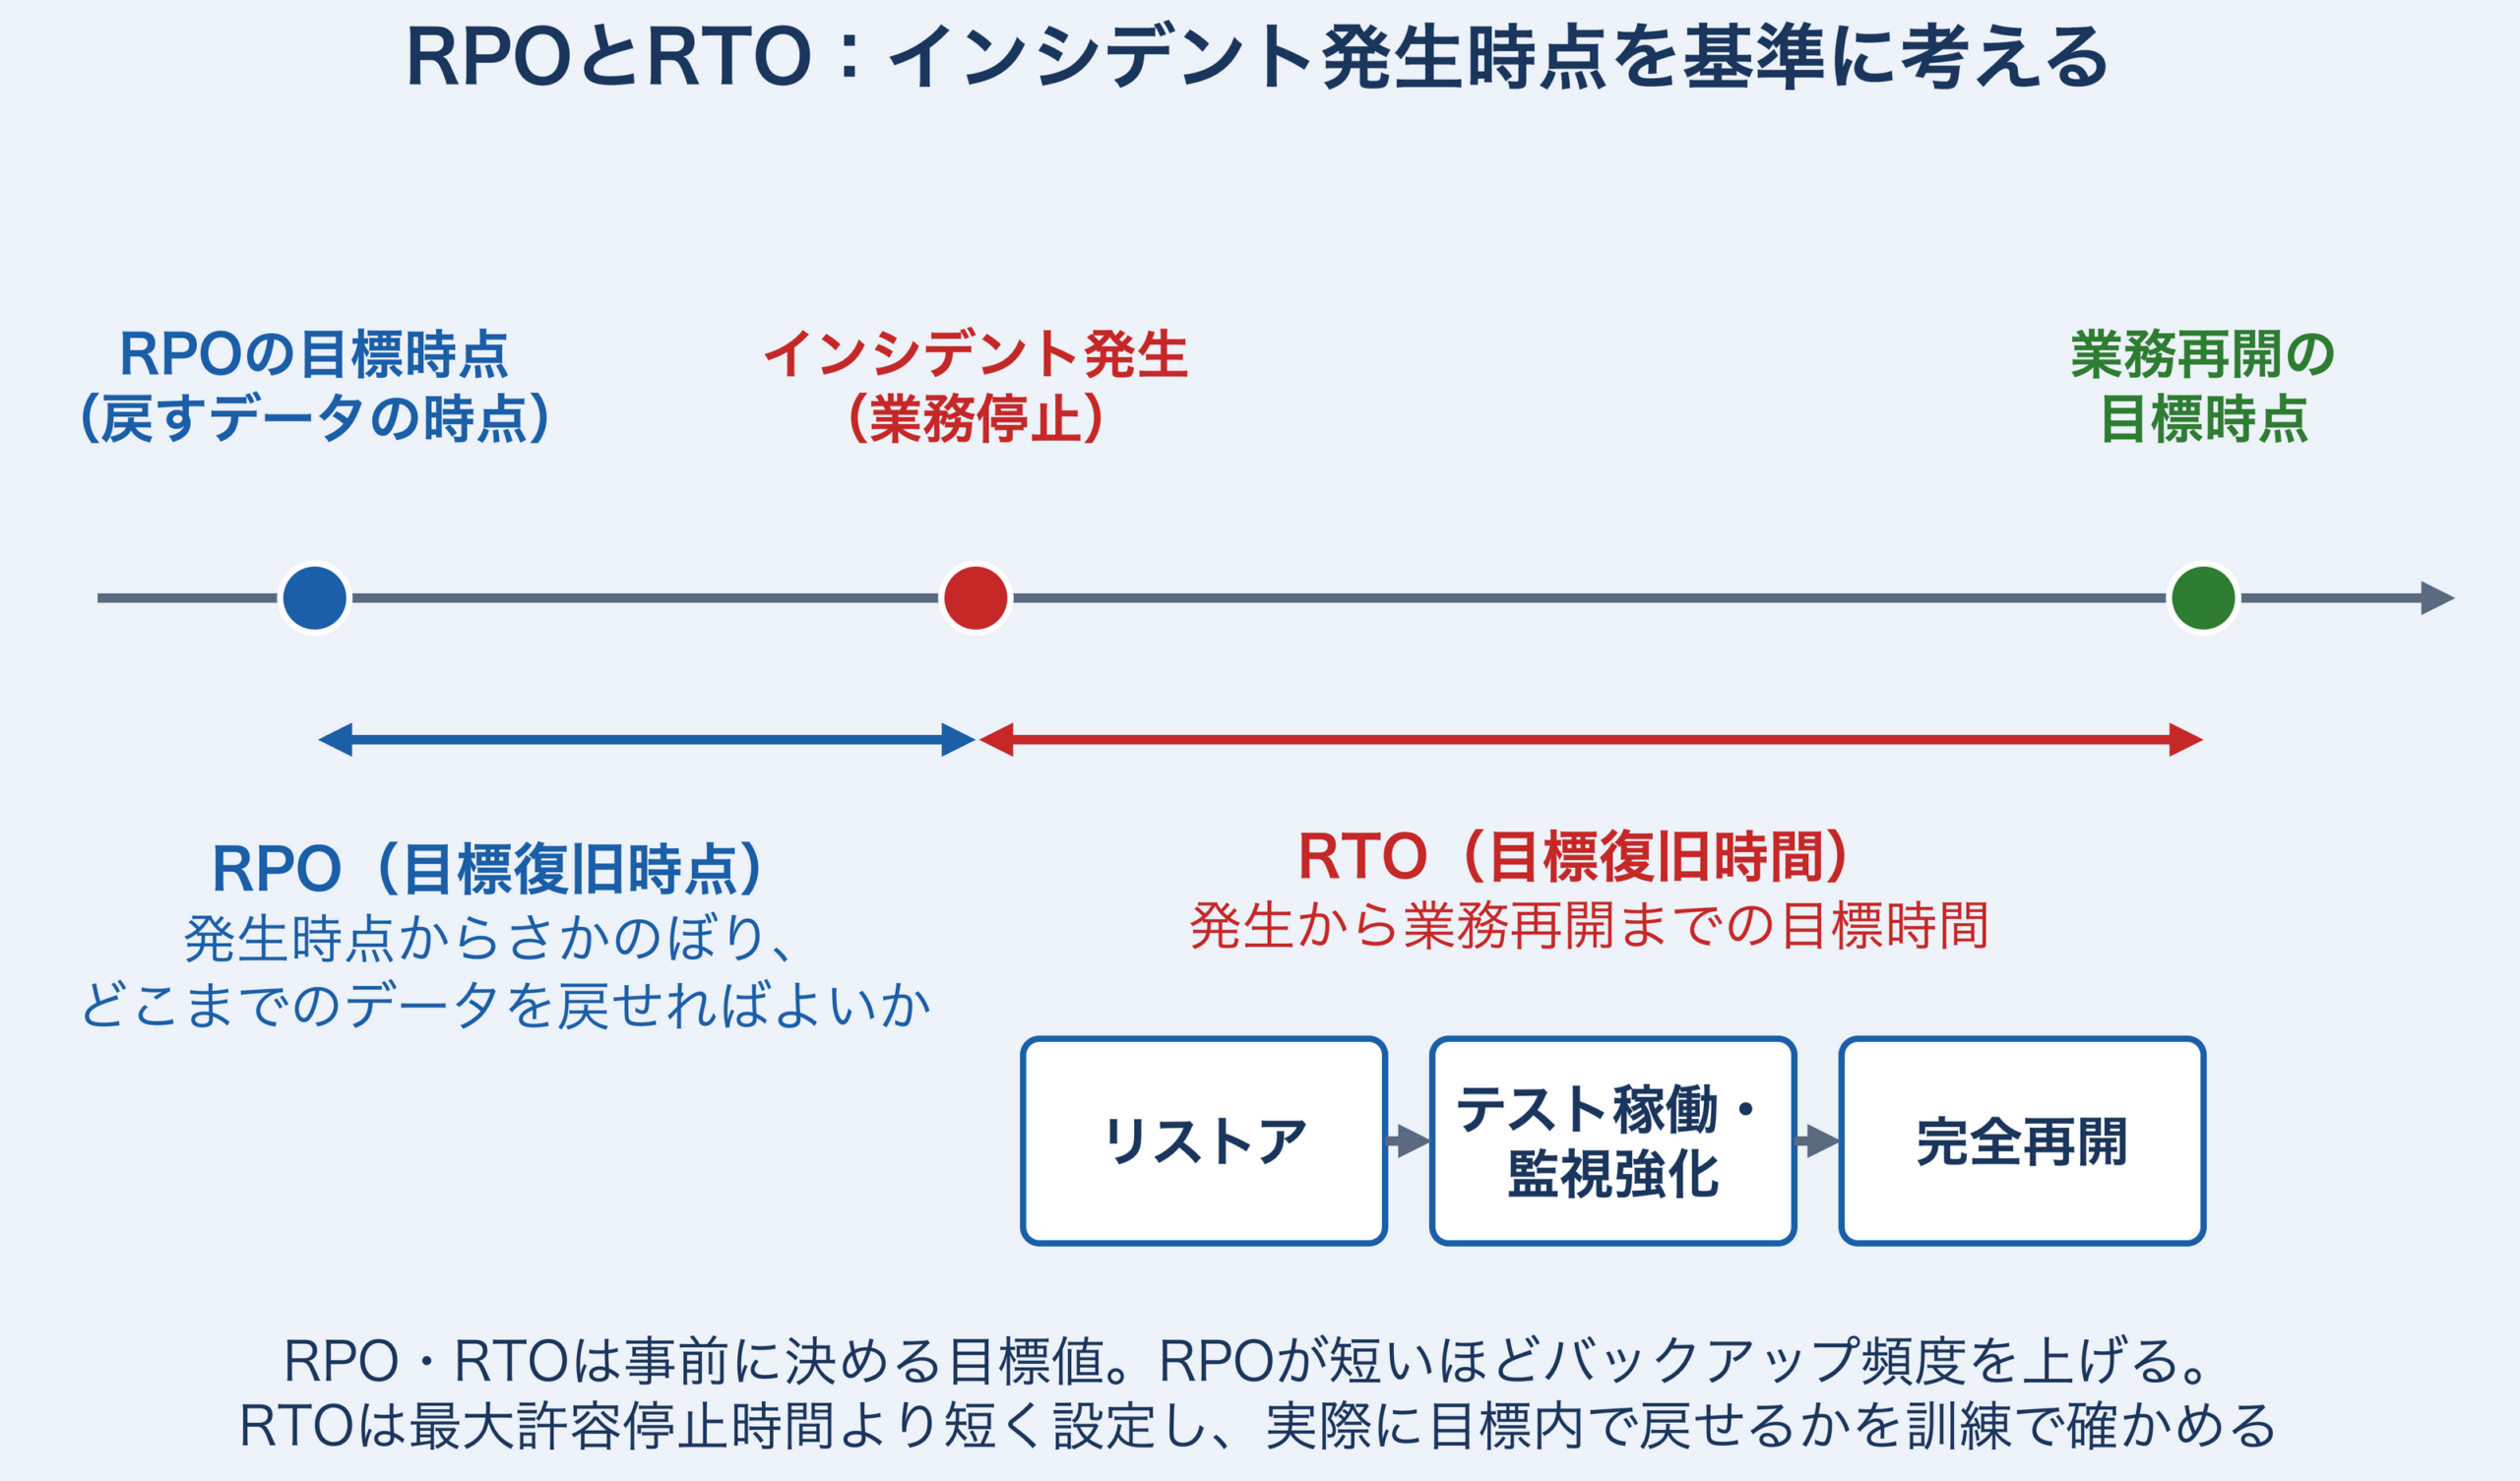
復旧目標指標(RPOとRTO)
復旧においては、以下の2つの指標が重要になります:
- RPO(Recovery Point Objective:目標復旧時点):インシデント発生時点からさかのぼって、どの時点のデータまで戻せればよいか。例えば、前日の夜のバックアップまで戻れば許容範囲なのか、1分前のデータが必要なのか
- RTO(Recovery Time Objective:目標復旧時間):業務やシステムを再開するまでの目標時間。起点はインシデント(業務停止)の発生時点で、最大許容停止時間(MTPD)より短く設定する
これらはインシデントが起きてから決めるものではなく、BCP(事業継続計画)として事前に定めておくべき事項です。RPO・RTOはあくまで目標値なので、実際の復旧結果が目標内に収まるかどうかを、復旧訓練で確かめておきます。
バックアップ戦略の重要性:3-2-1ルール
ランサムウェア対策として、バックアップの重要性が再認識されています。しかし、攻撃者は「バックアップデータそのもの」も暗号化・破壊しようとします。
そこで重要になるのが、バックアップの3-2-1ルールです:
- 3つのデータコピーを持つ(本番データ + バックアップ2つ)
- 2つの異なる媒体に保存する(ディスク、テープ、クラウドなど)
- 1つは遠隔地(オフサイト)に保管する
さらに最近では、イミュータブル(変更不可)バックアップが注目されています。一度書き込んだら一定期間は削除も上書きもできない設定にすることで、管理者権限を奪った攻撃者であってもバックアップを破壊しにくくする仕組みです(ただし、保持設定を管理者が解除できるモードもあるため、設定方式の確認が必要です)。復旧を成功させるためには、平時のバックアップ戦略が生命線となります。
事後対応(Post-Incident Activity):失敗を糧にする
システムが復旧し、業務が再開されると、現場は「あぁ、終わった」と安堵して通常業務に戻りたがります。しかし、インシデントレスポンスにおいて最も価値があるのは、実はこの事後対応フェーズです。
インシデント報告書の作成
一連の対応が終わったら、記憶が新しいうちに「インシデント報告書」を作成します:
- 何が起きたのか(事実経過)
- 原因は何だったのか(根本原因)
- 対応は適切だったか(評価)
- 何が足りなかったのか(課題)
このレポートは、経営層への報告だけでなく、システム運用の改善計画書としての役割も持ちます。
教訓の活用(Lessons Learned)とPDCAサイクル
「なぜ防げなかったのか」だけでなく、「対応のこの部分で時間がかかりすぎた」「連絡網が機能しなかった」といった反省点を洗い出します。
インシデント対応のプロセスは、一度決めたら終わりの静的なものではありません。実際のインシデント対応で得た教訓をもとに、プレイブック(対応手順書)を更新し、組織の対応能力をレベルアップさせる。このPDCAサイクルを回すことが、組織のセキュリティ強度を高めるうえで欠かせません。
法的・社会的責任への対応
インシデントレスポンスは技術的な問題だけではありません。特に個人情報保護法やGDPR(EU一般データ保護規則)などの法規制への対応が求められます。
- 個人情報保護委員会への報告:個人の権利利益を害するおそれが大きい漏えい等(要配慮個人情報、財産的被害のおそれがあるもの、不正の目的によるもの、1,000人を超えるもの)が発生した、または発生したおそれがある場合、速報(速やかに。ガイドラインでは概ね3〜5日以内)と確報(30日以内。不正の目的によるおそれがある場合は60日以内)を報告する義務がある。速報は報告対象の事態を知った後速やかに(目安は概ね3〜5日以内)、確報は事態を知った日から30日以内(施行規則第7条第3号の不正の目的によるおそれがある場合は60日以内)に行う
- 本人への通知:上記の報告対象となる事態では、本人への通知も原則として義務化されている(通知が困難な場合は公表等の代替措置)。通知は、事態の状況に応じて速やかに行う
- 対応のタイミング:報告と本人への通知は、復旧を待ってから行うものではありません。封じ込めや根絶と並行して、対応の途中から進めます
※上記は、2022年4月施行の改正個人情報保護法(2024年4月の施行規則改正を含む)に基づく現行ルールです。2026年7月に公布された改正個人情報保護法では、本人の権利利益の保護に欠けるおそれが少ない場合に本人への通知義務を緩和することが決まっており、原則として公布から2年以内に施行されます。実際の対応時は、個人情報保護委員会の最新情報を確認してください。
これらを怠ると、法的なペナルティだけでなく、企業の社会的信用の失墜(レピュテーションリスク)につながります。広報や法務と連携し、「隠蔽せず、誠実に、迅速に」情報を開示することが、結果として企業を守ることになります。
インシデントレスポンスを成功させるための3つのポイント
ここまで4つのステップと事後対応を見てきましたが、これらをスムーズに実行するために、平時から意識すべきポイントを整理します。
1. 役割分担の明確化(CSIRTの構築)
インシデント発生時に「誰がリーダーか」「誰が広報担当か」「誰が技術調査をするか」が決まっていないと、現場は混乱します。これを組織化したのがCSIRT(Computer Security Incident Response Team)です。
専任の組織を作るのが難しい場合でも、兼任でメンバーを選出し、緊急時の役割を決めておく必要があります。
2. コミュニケーションルートの確立
技術的な対応だけでなく、法務部、広報部、経営層、そして外部ベンダーや警察、監督官庁との連携も必要になります。「誰に、どのタイミングで、どのような手段で」連絡するかのフロー図(連絡網)を用意しておきましょう。
また、社内のメールシステム自体が使えなくなる(侵害される)可能性を考慮し、代替の連絡手段(チャットツールや緊急用携帯電話など)を確保しておくことも重要です。
3. 定期的な訓練の実施
手順書を作っただけでは、いざという時に体は動きません。避難訓練と同様に、インシデント対応訓練が必要です。
机上でシナリオを辿る「机上訓練」や、実際に疑似攻撃を行って検知・対応を確認する「実動訓練」を定期的に実施し、手順書の不備を見つけ出します。
インシデント対応の「型」を身につける意義
ここまで詳細に解説してきましたが、最後に改めてお伝えしたいのは、「型(フレームワーク)」を身につけることの意義です。
武道やスポーツと同じで、基本の型が身についていないと、応用動作はできません。インシデントという有事の際は、誰もがパニックになります。普段は優秀なエンジニアでも、焦りからコマンドを打ち間違えたり、連絡を忘れたりします。
そんな時、「次は封じ込めだ」「次は根絶だ」というロードマップ(型)が頭にあれば、思考停止に陥ることなく、次の一歩を踏み出すことができます。
このブログ記事で紹介した「検知・封じ込め・根絶・復旧」の流れを、ぜひあなたの「型」としてインストールしてください。そして、日々の学習や業務の中で、各ステップの解像度を高めていってください。それが、あなた自身と、あなたの守るべき組織を救う力になるはずです。
SC試験対策のポイント
インシデントレスポンスは、科目A-2(旧午前II)では用語の定義として、科目B(旧午後)では事例の中の判断として問われやすいテーマです。それぞれの押さえどころを整理します。
科目A-2(旧午前II)で問われる用語
用語の定義を、似た用語と区別して答えられるようにしておきます。
- トリアージ:アラートやインシデントの緊急度・影響度を判断し、対応の優先順位を決めること。誤検知は記録してクローズする
- RPO(目標復旧時点):インシデント発生時点からさかのぼって、どの時点のデータまで戻せればよいか。バックアップの取得間隔を決める根拠になる
- RTO(目標復旧時間):インシデント(業務停止)の発生時点から、業務やシステムを再開するまでの目標時間。MTPDより短く設定する
- フォレンジック:証拠を保全し、何が起きたかを解析すること。揮発性の高い情報(メモリなど)から順に収集する
- 3-2-1ルール:データのコピーを3つ持ち、2種類の媒体に保存し、1つは遠隔地に置くバックアップの原則
- NIST SP 800-61 Rev.2の4フェーズ:準備 → 検知と分析 → 封じ込め・根絶・復旧 → 事後対応の順序。実際には、根絶中に新たな痕跡が見つかれば検知と分析に戻るなど、各フェーズを反復する
科目Bでの解答アプローチ
科目Bでは、事例の文章を読み、次のような観点で記述させる設問が考えられます。
- どのフェーズ・ステップに当たるか:事例中の行動が、NISTの4フェーズ(または本記事の4ステップ)のどこに当たるかを答える。「端末をネットワークから切り離した」なら封じ込め、「侵入経路となった脆弱性を恒久的に修正した(パッチ適用・設定修正)」なら根絶。業務を止めずに時間を稼ぐ暫定的なパッチ適用は封じ込め(長期)
- 電源を切らない理由:電源を切ると、メモリ上にしかない情報(実行中のプロセス、ネットワーク接続、ファイルレスマルウェアなど)が失われ、原因究明に必要な証拠の一部を失うから、と答える
- RPO/RTOからのバックアップ方式の選択:RPOが短いほど取得間隔を短くする(あるいはレプリケーションを使う)必要があり、RTOが短いほど復元に時間がかからない方式を選ぶ必要がある、と条件から逆算する
各ステップで「なぜその行動が必要なのか」「どんな判断基準があるのか」を理解しておくと、事例が変わっても解答の筋道を立てやすくなります。
【演習】インシデントレスポンスのフェーズ 理解度チェック(全10問)
科目A-2では、NISTの4フェーズの順序やトリアージ・RPO・RTOといった用語の定義が、科目Bでは事例中の行動がどのフェーズに当たるかや、電源を切らない理由が問われやすく、NISTの4フェーズの順序の入れ替え、RPOとRTOの取り違え、封じ込め前の再インストールといったひっかけに注意が必要です。以下の練習問題で本記事の理解度を確認してみましょう。
まとめ:準備なきところに、適切な対応なし
インシデントレスポンスは、単なる技術的なトラブルシューティングではありません。組織の危機管理能力そのものです。
「検知・封じ込め・根絶・復旧」という4つのステップは、暗記するためのものではなく、混乱した現場で冷静な判断を下すための羅針盤です。攻撃者は常に新しい手口で攻めてきますが、この基本的な対応の流れは大きく変わりません。
重要なのは、インシデントが起きていない「平時」にこそ、これらの手順が機能するかどうかを確認し、準備をしておくことです。
「うちは狙われないだろう」という正常性バイアスを捨て、「今日、これから攻撃を受けるかもしれない」という意識で、自組織のインシデント対応計画(IRP)を一度見直してみてはいかがでしょうか。
インシデント対応を行う際に証拠を保全するための技術については、デジタルフォレンジックの証拠保全手順6ステップで掘り下げて解説しています。あわせて確認しておきましょう。
本記事は情報処理安全確保支援士(SC)試験対策を目的として作成しています。
参考資料
- NIST SP 800-61 Rev. 2, Computer Security Incident Handling Guide(2012年、2025年4月に廃止)
- NIST SP 800-61 Rev. 3, Incident Response Recommendations and Considerations for Cybersecurity Risk Management: A CSF 2.0 Community Profile(2025年4月)
- RFC 3227, Guidelines for Evidence Collection and Archiving
- CISA #StopRansomware Guide
- 個人情報保護委員会「漏えい等の対応とお役立ち資料」
- 個人情報保護委員会「個人情報の保護に関する法律についてのガイドライン(通則編)」
- 個人情報保護委員会「令和8年 改正個人情報保護法について」
テンプレート集
+おまけ:毎日1通の無料メール講座つき。登録した日が「1日目」、図解と論理で16週間かけて基礎も固まります。

